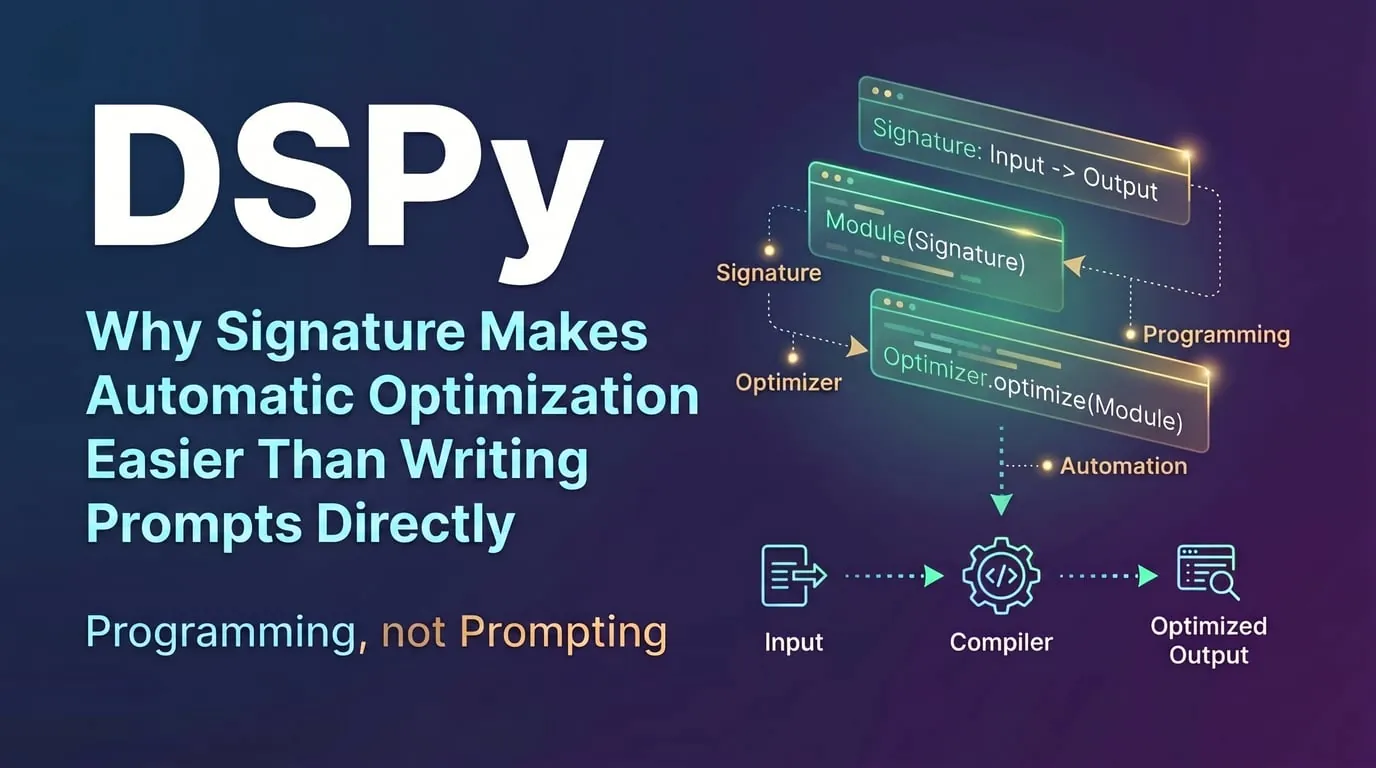
Una de las cosas mas utiles que encontre construyendo productos recientemente fue DSPy.
Mientras armaba el pipeline de generacion de contenido de Canviz, me encontre una y otra vez con el mismo problema de ingenieria: la calidad de la explicacion y la utilidad del script de pizarra eran dos objetivos importantes, pero era dificil mantener ambos estables usando solo prompt text. En cuanto cambiaba de modelo o agregaba un nuevo grado escolar, tenia que volver a ajustar la cadena. DSPy me dio una forma mucho mas sistematica de abordarlo.
Si buscas un DSPy tutorial, una forma mas sistematica de hacer prompt engineering o una mejor manera de optimizar pipelines con LLM, la idea central es esta: primero defines la tarea como una Signature y despues dejas que DSPy optimice la capa de prompting.
La contradiccion central del prompt engineering
Antes de hablar de DSPy, vale la pena dejar clara una idea: por que escribir prompts a mano es un problema de ingenieria, y no solo de tecnica?
Los prompts tradicionales tienen una falla estructural: mezclan "que quiero hacer" con "como le digo al modelo que lo haga".
Esa unica cadena en lenguaje natural esta haciendo dos trabajos a la vez:
- Describe la logica de la tarea: cuales son las entradas y cuales deben ser las salidas.
- Funciona como una especie de conjuro ajustado para el modelo actual.
Tomemos un ejemplo de educacion matematica. La logica de la tarea "explicar un problema de gallinas y conejos a un estudiante" es estable. Pero el conjuro que funciona bien para GPT puede no ser el mismo que funciona bien para Claude Sonnet. Si cambias de modelo, o si pasas de tercer grado a quinto grado, ese conjuro puede romperse. Y lo peor es que casi nunca hay una forma sistematica de arreglarlo: normalmente solo queda prueba y error.
Eso es hardcoding con otro nombre. En ingenieria de software ya sabemos que no debemos congelar la logica central dentro de literales fragiles. En los pipelines con LLM, sin embargo, muchas veces metemos el comportamiento central dentro de un string fragil.
El autor de DSPy, Omar Khattab de Stanford, resume el problema asi:
Muchos pipelines de LM se implementan como plantillas de prompt hardcodeadas descubiertas por prueba y error, y son inusualmente fragiles.
Que es DSPy y cual es su intuicion principal?
DSPy (Declarative Self-improving Python) es un framework abierto por Stanford NLP en 2023 y publicado en ICLR 2024. Su idea central es:
Programming language models, not prompting them.
La solucion es elegante: separar la interfaz de la tarea de la implementacion concreta del prompt.
Tu le dices a DSPy:
- que entra y que sale en cada paso,
- cual es la estructura del pipeline,
- y como se evalua el exito.
Luego el compilador y el optimizador de DSPy buscan una mejor estrategia de prompt para tu modelo, tus datos y tu metrica.
La analogia oficial ayuda: se parece un poco a pasar de ensamblador a un lenguaje de mas alto nivel, o de SQL escrito a mano a un ORM.
Tres conceptos para entender DSPy
1. Signature: la firma de tipos de la tarea
Una Signature es la descripcion de interfaz en DSPy. Especificas que hace el paso, no como redactarlo:
import dspy

class ExplainMathProblem(dspy.Signature):
    """Explain a math problem to a student at a specified grade level."""
    problem: str = dspy.InputField(desc="Original math problem")
    grade: int = dspy.InputField(desc="Student grade, e.g. 3 means third grade")
    explanation: str = dspy.OutputField(desc="A step-by-step explanation suitable for the grade")
    key_concept: str = dspy.OutputField(desc="The main concept tested by the problem")
Aqui no hay ningun prompt escrito a mano. Solo hay semantica de interfaz, no frases del tipo "You are a patient math teacher".
2. Module: bloques funcionales componibles
Los Modules son las unidades de ejecucion de DSPy, inspiradas en nn.Module de PyTorch. Puedes componerlos para formar un pipeline completo:
class MathLessonPipeline(dspy.Module):
    def __init__(self):
        # Step 1: explain the problem
        self.explain = dspy.ChainOfThought(ExplainMathProblem)
        # Step 2: generate a matching DinoGSP visualization script
        self.generate_diagram = dspy.Predict(
            "problem, explanation -> dinogsp_script: str"
        )
        # Step 3: create a similar practice exercise
        self.make_exercise = dspy.Predict(
            "problem, key_concept, grade -> exercise: str, answer: str"
        )

    def forward(self, problem, grade):
        # Explain
        step1 = self.explain(problem=problem, grade=grade)
        # Generate diagram
        step2 = self.generate_diagram(
            problem=problem,
            explanation=step1.explanation
        )
        # Create exercise
        step3 = self.make_exercise(
            problem=problem,
            key_concept=step1.key_concept,
            grade=grade
        )
        return dspy.Prediction(
            explanation=step1.explanation,
            dinogsp_script=step2.dinogsp_script,
            exercise=step3.exercise,
            answer=step3.answer
        )
En todo el pipeline de tres pasos no estas escribiendo prompts manualmente. Lo que escribes es la estructura logica.
DSPy tambien incluye varias estrategias de razonamiento comunes:
| Modulo | Estilo de razonamiento | Ejemplo de uso en educacion |
|---|---|---|
dspy.Predict | prediccion directa | clasificacion de dificultad, etiquetado de conceptos |
dspy.ChainOfThought | cadena de pensamiento | explicaciones paso a paso |
dspy.ReAct | ciclo pensar-actuar | validacion de scripts con herramientas |
dspy.ProgramOfThought | razonamiento programatico | generacion de codigo matematico ejecutable |
3. Optimizer: el motor de ajuste automatico
Esta es la parte mas distintiva de DSPy.
Tu proporcionas:
- un dataset de evaluacion, por ejemplo 100 problemas con referencias anotadas por humanos,
- y una funcion metrica que decida si la salida es suficientemente buena.
Despues el optimizador busca mejores instrucciones de prompt y mejores combinaciones de ejemplos few-shot:
# Define the metric: is the explanation age-appropriate, and does the script parse?
def lesson_quality_metric(example, prediction, trace=None):
    explanation_ok = len(prediction.explanation) > 50  # minimum length
    script_parseable = validate_dinogsp(prediction.dinogsp_script)  # valid script
    grade_appropriate = check_vocabulary_level(
        prediction.explanation, example.grade
    )  # age-appropriate wording
    return explanation_ok and script_parseable and grade_appropriate

# Optimize with MIPROv2
optimizer = dspy.MIPROv2(metric=lesson_quality_metric, auto="medium")
optimized_pipeline = optimizer.compile(
    MathLessonPipeline(),
    trainset=annotated_lessons
)

# Save the result and load it directly in production later
optimized_pipeline.save("./optimized_math_lesson.json")
Una ejecucion medium consume tiempo y dinero, pero a cambio obtienes un sistema ajustado para un modelo, un dataset y una metrica concretos, no solo un prompt afortunado.
Un dato que vale la pena mirar
Hay un resultado oficial de DSPy que me parecio muy llamativo, en HotPotQA, un benchmark de razonamiento multi-hop.
Usando dspy.ReAct con una familia gpt mini:
- la accuracy era de alrededor de 24% antes de optimizar,
- y subio a alrededor de 51% despues de optimizar con MIPROv2 sobre 500 ejemplos.
Lo importante no es que se haya usado un modelo mas caro. Lo importante es que el mismo tipo de modelo se volvio mucho mejor en la tarea mediante optimizacion.
En que se diferencia de LangChain y LlamaIndex
Una pregunta razonable es si DSPy importa si ya usas LangChain.
LangChain / LlamaIndex son frameworks de orquestacion. Son buenos conectando LLMs, vectores, retrieval y tool calls, pero los prompts siguen siendo, en general, strings escritos por humanos. Cuando cambia el modelo, muchas veces tambien toca volver a editar los prompts manualmente.
DSPy se parece mas a un framework compilador para programas de IA. No solo conecta componentes. Tambien intenta encargarse de la generacion y optimizacion del prompt. El desarrollador escribe la logica; DSPy busca una mejor realizacion en lenguaje natural para un modelo concreto.
La diferencia se ve muy clara en un pipeline de educacion matematica:
- Con LangChain, si construiste un flujo para "explicaciones de tercer grado" y manana necesitas soporte para quinto grado, normalmente vuelves a tocar los prompts a mano.
- Con DSPy, es mas probable que cambies entradas, dataset o metrica, recompiles y dejes que el framework vuelva a buscar.
Si tuviera que resumirlo en una analogia: LangChain es una linea de automatizacion; DSPy es un lenguaje de mas alto nivel con compilador.
Mi mirada de desarrollador: que resuelve y que todavia no
Lo que DSPy realmente resuelve
- Dolor de migracion entre modelos: al pasar de GPT-5.4 a un modelo mas barato, puedes recompilar en vez de reescribir todos los prompts.
- Optimizacion conjunta entre pasos: la calidad de la explicacion y la utilidad del script se pueden optimizar juntas.
- Reproducibilidad experimental: los resultados optimizados se pueden guardar como JSON y compartir en equipo.
Donde sigue siendo dificil
- Las metricas son la parte mas dura: una funcion como
validate_dinogsp()debe estar muy bien definida, o el optimizador explotara huecos. - Optimizar no es gratis: a medida que crecen el dataset, el costo del modelo y las rondas, tambien crece la factura.
- La depuracion todavia esta madurando: cuando el pipeline optimizado no alcanza, no siempre es facil saber si el problema es el dataset, la metrica o el propio modelo.
Cuando conviene usar DSPy?
Buen encaje
- Estas construyendo un pipeline LLM de varios pasos.
- Necesitas cambiar entre distintos modelos.
- Tienes un dataset de evaluacion y objetivos medibles.
- Estas cansado de ajustar prompts por intuicion.
- Necesitas algo mantenible en produccion.
Probablemente no conviene
- Solo estas validando una idea rapidamente.
- La tarea no tiene una metrica clara, asi que el optimizador no tiene una senal confiable.
Cierre
Lo que mas me gusta de DSPy no es solo que pueda optimizar prompts automaticamente. Lo valioso es la mentalidad de ingenieria que empuja:
En un pipeline de IA, los prompts se parecen mas a parametros que a codigo fuente.
Igual que no meteria los pesos de una red neuronal directamente en el codigo, tampoco deberia tratar un prompt afinado para un solo modelo como si fuera la logica del programa. Es mejor ver esos prompts como artefactos que pueden aprenderse, optimizarse, guardarse y migrarse.
La logica del contenido educativo es estable: explicacion paso a paso, apoyo visual y lenguaje apropiado para la edad. Pero la forma de lograr que el modelo haga eso cambia cuando cambian los modelos, los grados escolares y los tipos de problema. DSPy separa esas dos capas, y por eso vuelve al sistema mucho mas mantenible.
Si estas construyendo en educacion con IA, generacion de contenido o sistemas multi-step de agentes, vale la pena mirarlo en serio.
Referencias
- Documentacion de DSPy: dspy.ai
- Paper: DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines, ICLR 2024
- GitHub: stanfordnlp/dspy
- Guia de optimizers: dspy.ai/learn/optimization/optimizers