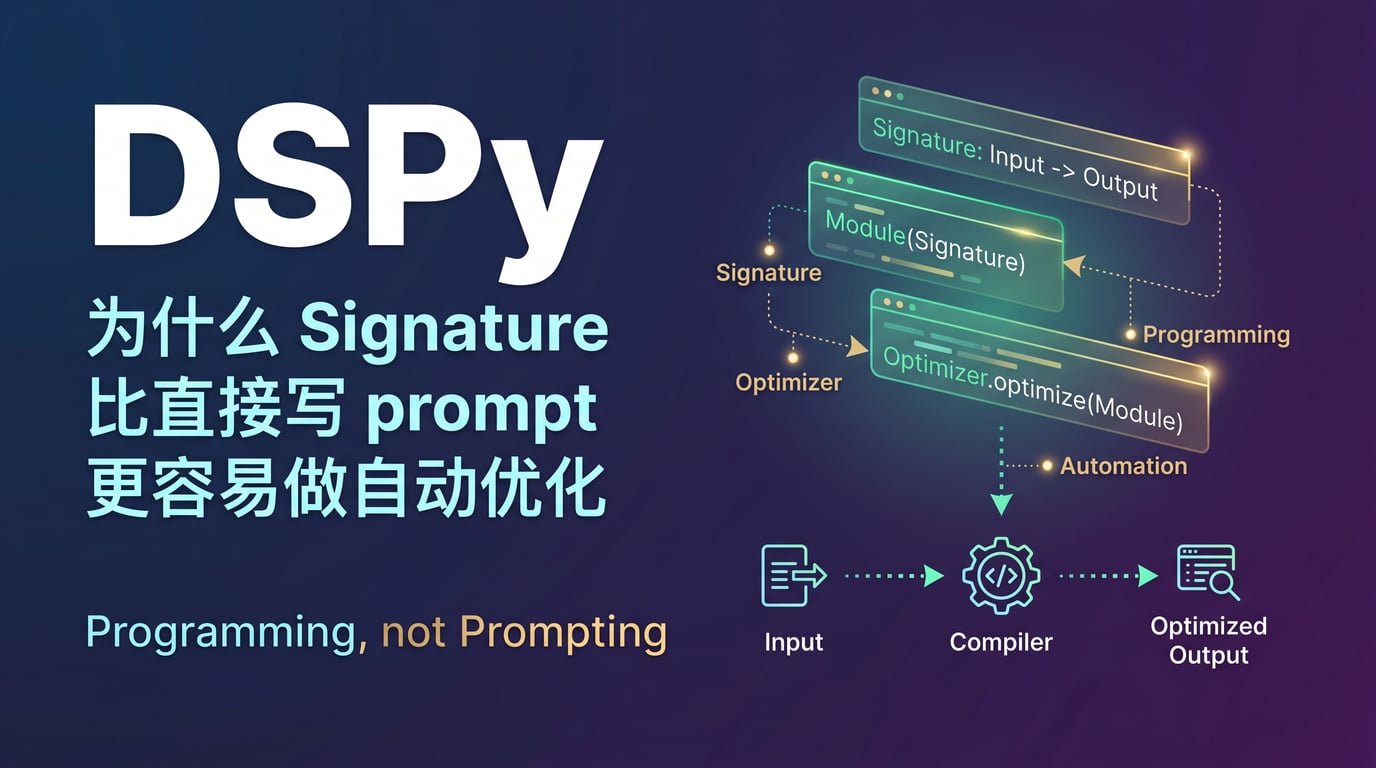
在做项目中发现的好东西:DSPy。
在搭 Canviz 的内容生成 pipeline 时,我遇到了一个反复出现的工程问题:题目讲解质量和画板脚本可用性这两个目标,很难同时只靠 prompt 维持稳定。一旦换模型,或者加新年级,就要重新调一遍字符串。DSPy 给了我一个系统性的方案,值得单独拿出来分享。
Prompt 工程的根本矛盾
在聊 DSPy 之前,先把一个问题说清楚:为什么手写 prompt 是一个工程问题,而不只是技巧问题?
传统 prompt 有一个致命缺陷:它把“我要做什么”和“怎么告诉模型做”混在了一起。
写下来的那段自然语言提示词,同时承担了两件事:
- 描述任务的逻辑,也就是接受什么输入、产出什么输出。
- 充当面向当前模型调出来的“咒语”。
以数学教学场景为例,“讲解一道鸡兔同笼题”这个任务的逻辑是稳定的;但要让 GPT 讲好,和让 Claude Sonnet 讲好,背后的那段咒语可能完全不同。一旦换了模型,或者年级从三年级变成五年级,这段咒语就可能失效。更糟糕的是,通常没有系统性的修复方式,只能靠直觉试错。
这就是软件工程里的硬编码问题。普通程序里,我们早就知道不该把核心逻辑硬写死;但在 AI pipeline 里,最核心的逻辑却经常被锁进一个脆弱字符串里。
DSPy 的作者、斯坦福的 Omar Khattab 把这个问题概括为:
现有的 LM pipeline 通常用硬编码的 prompt 模板实现,这些字符串靠试错发现,异常脆弱。
DSPy 是什么?它的核心洞察是什么?
DSPy(Declarative Self-improving Python) 是斯坦福 NLP 实验室在 2023 年开源的框架,并发表于 ICLR 2024。它的核心主张是:
Programming language models, not prompting them.
对 AI 编程,而不是对 AI 提示。
它的解法很优雅:把任务的接口描述与具体 prompt 实现彻底分离。
开发者只需要告诉 DSPy:
- 这个步骤输入什么、输出什么。
- 整个 pipeline 的逻辑结构是什么。
- 你的评价标准是什么。
然后 DSPy 的编译器(Compiler)和优化器(Optimizer)会自动去找更适合当前模型、当前数据、当前指标的 prompt 方案。
如果借用官方的比喻,这有点像从汇编跳到高级语言,或者从手写 SQL 跳到 ORM。
三个核心概念,看懂 DSPy 的全貌
1. Signature:任务的类型签名
Signature 是 DSPy 的接口描述。你用类似类型声明的方式告诉框架这个步骤做什么,而不是怎么做:
import dspy

class ExplainMathProblem(dspy.Signature):
    """为指定年级的学生讲解一道数学题,语言要符合该年级的认知水平。"""
    problem: str = dspy.InputField(desc="数学题目原文")
    grade: int = dspy.InputField(desc="学生年级,如 3 表示三年级")
    explanation: str = dspy.OutputField(desc="适合该年级的分步骤讲解,语言亲切易懂")
    key_concept: str = dspy.OutputField(desc="这道题考察的核心知识点,一句话说清楚")
这里完全没有写 prompt。只有接口语义,没有“你是一位温柔耐心的数学老师”这一类面向模型的描述。
2. Module:可组合的功能模块
Module 是 DSPy 的执行单元,灵感来自 PyTorch 的 nn.Module。你可以像搭积木一样,把多个步骤组合成完整 pipeline:
class MathLessonPipeline(dspy.Module):
    def __init__(self):
        # 第一步:讲解题目
        self.explain = dspy.ChainOfThought(ExplainMathProblem)
        # 第二步:根据讲解生成对应的大角几何可视化脚本
        self.generate_diagram = dspy.Predict(
            "problem, explanation -> dinogsp_script: str"
        )
        # 第三步:出一道同类型的练习题
        self.make_exercise = dspy.Predict(
            "problem, key_concept, grade -> exercise: str, answer: str"
        )

    def forward(self, problem, grade):
        # 讲解
        step1 = self.explain(problem=problem, grade=grade)
        # 生成图形
        step2 = self.generate_diagram(
            problem=problem,
            explanation=step1.explanation
        )
        # 出练习题
        step3 = self.make_exercise(
            problem=problem,
            key_concept=step1.key_concept,
            grade=grade
        )
        return dspy.Prediction(
            explanation=step1.explanation,
            dinogsp_script=step2.dinogsp_script,
            exercise=step3.exercise,
            answer=step3.answer
        )
整条三步 pipeline 没有手写任何 prompt,写的全是逻辑结构。
DSPy 内置了几个常见的推理策略模块:
| 模块 | 对应方式 | 在教学中的应用 |
|---|---|---|
dspy.Predict | 直接预测 | 题目难度分级、知识点标注 |
dspy.ChainOfThought | 链式思维 | 分步骤解题讲解 |
dspy.ReAct | 思考-行动循环 | 调用外部工具验证脚本 |
dspy.ProgramOfThought | 程序化思维 | 生成可执行的数学计算代码 |
3. Optimizer:自动调优引擎
这是 DSPy 最独特的部分。
你只需要提供:
- 一个评估数据集,比如 100 道题和对应人工标注样本。
- 一个评估指标函数,用来判断生成结果是不是足够好。
然后调用优化器,它会自动搜索更优的 prompt 指令和 few-shot 示例组合:
# 定义评估指标:讲解是否适龄、图形脚本是否能被解析
def lesson_quality_metric(example, prediction, trace=None):
    explanation_ok = len(prediction.explanation) > 50  # 基本长度
    script_parseable = validate_dinogsp(prediction.dinogsp_script)  # 脚本可用
    grade_appropriate = check_vocabulary_level(
        prediction.explanation, example.grade
    )  # 用词适龄
    return explanation_ok and script_parseable and grade_appropriate

# 用 MIPROv2 进行优化
optimizer = dspy.MIPROv2(metric=lesson_quality_metric, auto="medium")
optimized_pipeline = optimizer.compile(
    MathLessonPipeline(),
    trainset=annotated_lessons
)

# 保存结果,生产环境直接加载,不需要重新优化
optimized_pipeline.save("./optimized_math_lesson.json")
一次 medium 级优化也许会花一些时间和成本,但换来的是一个针对指定模型、指定数据、指定指标调优过的教学内容生成系统。
看看数据
DSPy 官方给过一组很有冲击力的数据。
在 HotPotQA 多跳推理任务上,用 dspy.ReAct 配合 gpt mini 系列:
- 优化前约 24% 准确率。
- 使用 MIPROv2 在 500 个样本上优化后,提升到约 51%。
核心意义不是“换了更贵模型”,而是让同一个模型更适合完成这类任务。
它和 LangChain / LlamaIndex 的本质区别
很多人会问:如果已经在用 LangChain 了,还需要 DSPy 吗?
LangChain / LlamaIndex 更像工具链编排框架。它们擅长把 LLM、向量数据库、工具调用等组件串起来,但 prompt 本身通常还是人手写的字符串。换个模型,很多时候还得自己回去改 prompt。
DSPy 更像 AI 程序编译框架。它不只是连接组件,还尝试接管 prompt 的生成与优化。开发者主要负责写逻辑,DSPy 负责把这套逻辑翻译成更适合特定模型的自然语言指令。
放到数学教学场景里更容易理解:
- 如果你用 LangChain 搭了“三年级讲解”的 pipeline,明天产品要求支持五年级,通常得手动回头改那些 prompt。
- 如果你用 DSPy,更多时候改的是输入条件和训练集,然后重新 compile,让框架为新的目标重新寻找更合适的提示策略。
如果一定要类比,LangChain 更像自动化流水线,DSPy 更像带编译器的高级语言。
我的开发者视角:它解决了什么,还差什么
DSPy 真正解决的问题
- 模型迁移的痛苦:从 GPT-5.4 换到更便宜的模型时,不必手改所有 prompt,可以重新 compile。
- 多步骤联合优化:讲解质量和图形脚本可用性这两个目标,以前很难一起调;DSPy 能把它们放进同一个优化过程。
- 实验可复现:优化结果可以保存成 JSON,便于团队共享和版本管理。
目前的局限
- 评估指标最难写:像
validate_dinogsp()这种函数必须自己定义,而且需要足够严格,否则优化器会“投机取巧”。 - 优化不是免费的:数据量、模型单价和优化轮数叠加之后,成本会明显上升。
- 调试体验仍在成熟中:优化后结果不理想时,往往很难立刻判断问题是数据、指标,还是模型能力边界。
什么时候应该用 DSPy?
适合的场景
- 你在做多步骤的 LLM pipeline。
- 你需要在不同模型之间迁移或切换。
- 你手里有评估数据集,且效果目标可以量化。
- 你不想再靠感觉手调 prompt。
- 你需要长期维护一个生产级 AI 系统。
不太合适的场景
- 只是快速验证一个 idea。
- 任务没有清晰指标,没法给优化器稳定反馈。
写在最后
我觉得 DSPy 最值得重视的,不只是“它能自动调 prompt”,而是它提出了一种更工程可靠的思维方式:
AI pipeline 里的 prompt,本质上更像程序参数,而不是程序源代码。
就像不会把神经网络权重硬编码进源文件一样,也不应该把某个模型调出来的 prompt 当成稳定逻辑本身。这些 prompt 更适合作为可学习、可优化、可保存、可迁移的产物。
教学内容的逻辑是稳定的,比如分步骤、有图示、适龄表达;但怎样引导模型做到这些,会随着模型更新、年级扩展、题型增加而不断变化。DSPy 把两者拆开,才让 AI 教学系统真正变得可维护。
如果你也在做 AI 教育、内容生成或多步骤 Agent pipeline,这个思路值得认真看一眼。