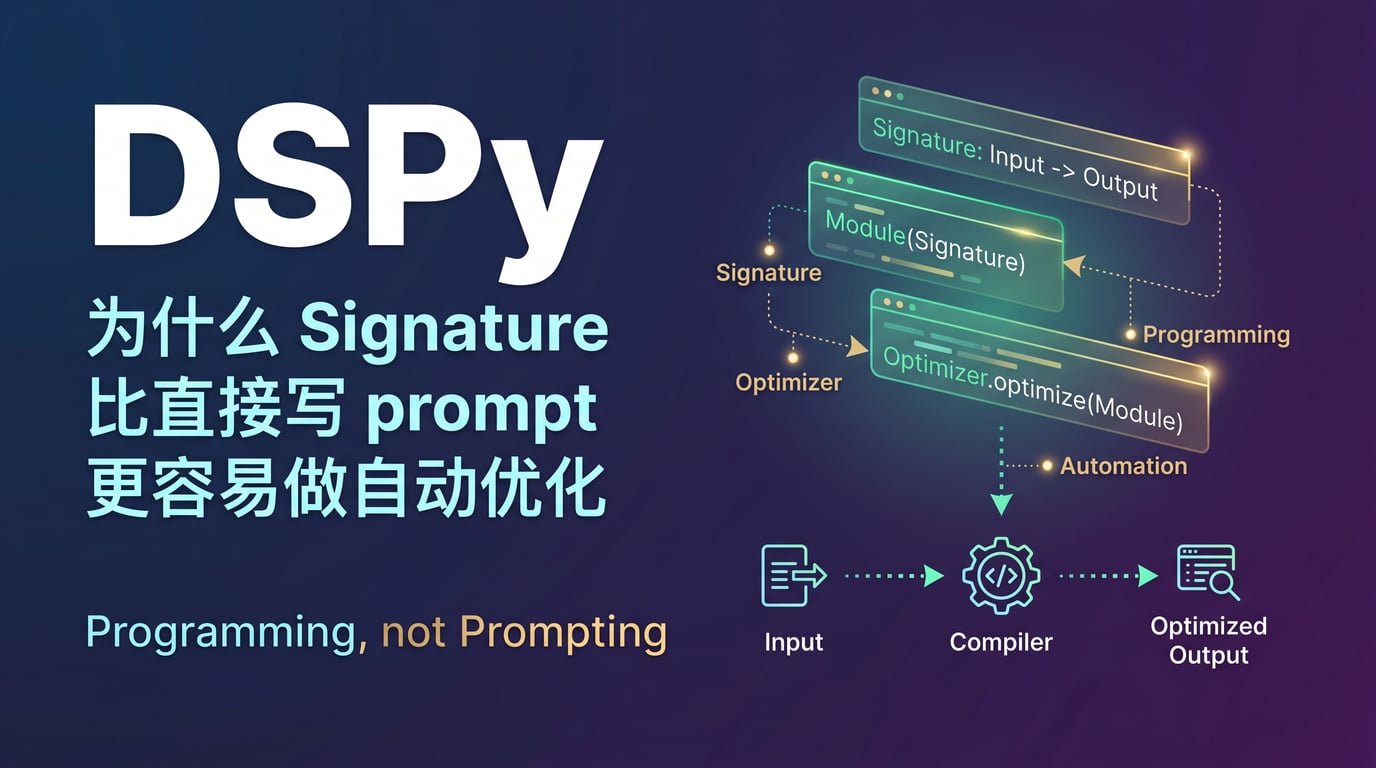
最近在做專案時遇到一個很值得單獨拿出來講的東西:DSPy。
在搭 Canviz 的內容生成 pipeline 時,我反覆遇到一個工程問題:題目講解品質和畫板腳本可用性這兩個目標,很難只靠 prompt 同時維持穩定。一旦換模型,或加入新年級,就得把那串字重新調一遍。DSPy 給了我一個更系統化的做法。
Prompt 工程的根本矛盾
在談 DSPy 之前,先把一件事說清楚:為什麼手寫 prompt 是工程問題,而不只是技巧問題?
傳統 prompt 有一個致命缺陷:它把「我要做什麼」和「我要怎麼告訴模型做」混在一起了。
那段自然語言提示詞,同時承擔了兩件事:
- 描述任務邏輯,也就是接受什麼輸入、輸出什麼結果。
- 扮演針對目前模型調出來的「咒語」。
以數學教學場景為例,「講解一道雞兔同籠題」這個任務的邏輯本身是穩定的;但要讓 GPT 講好,和讓 Claude Sonnet 講好,需要的那段咒語可能完全不同。一旦換模型,或年級從三年級變成五年級,這段咒語就可能失效。更麻煩的是,通常沒有系統性的修復方法,只能憑感覺試錯。
這其實就是軟體工程裡的硬編碼問題。一般程式裡,我們早就知道不該把核心邏輯寫死;但在 AI pipeline 裡,核心邏輯卻常常被鎖進一個脆弱字串裡。
DSPy 的作者、史丹佛的 Omar Khattab 對這件事有一個很準確的描述:
現有的 LM pipeline 通常用硬編碼的 prompt 模板實作,這些字串靠試錯找到,異常脆弱。
DSPy 是什麼?它的核心洞察是什麼?
DSPy(Declarative Self-improving Python) 是史丹佛 NLP 實驗室在 2023 年開源、並發表於 ICLR 2024 的框架。它的核心主張是:
Programming language models, not prompting them.
對 AI 編程,而不是對 AI 下提示。
它提供的解法很優雅:把任務介面描述與具體 prompt 實作徹底分開。
你只需要告訴 DSPy:
- 這一步輸入什麼、輸出什麼。
- 整個 pipeline 的邏輯結構是什麼。
- 你的評估標準是什麼。
接著由 DSPy 的編譯器(Compiler)和最佳化器(Optimizer)去替你搜尋更適合當前模型、資料與指標的 prompt 實現。
如果借用官方類比,這有點像從組合語言跳到高階語言,或者從手寫 SQL 跳到 ORM。
三個核心概念,看懂 DSPy 的全貌
1. Signature:任務的型別簽名
Signature 是 DSPy 的介面描述。你用類似型別宣告的方式告訴框架這一步要做什麼,而不是怎麼做:
import dspy

class ExplainMathProblem(dspy.Signature):
    """為指定年級的學生講解一道數學題,語言要符合該年級的認知水平。"""
    problem: str = dspy.InputField(desc="數學題目原文")
    grade: int = dspy.InputField(desc="學生年級,如 3 表示三年級")
    explanation: str = dspy.OutputField(desc="適合該年級的分步驟講解,語言親切易懂")
    key_concept: str = dspy.OutputField(desc="這道題考察的核心知識點,一句話說清楚")
這裡完全沒有手寫 prompt。只有介面語義,沒有「你是一位溫柔耐心的數學老師」這種模型導向的文字。
2. Module:可組合的功能模組
Module 是 DSPy 的執行單元,靈感來自 PyTorch 的 nn.Module。你可以像搭積木一樣,把多個步驟組成完整 pipeline:
class MathLessonPipeline(dspy.Module):
    def __init__(self):
        # 第一步:講解題目
        self.explain = dspy.ChainOfThought(ExplainMathProblem)
        # 第二步:根據講解生成對應的大角幾何可視化腳本
        self.generate_diagram = dspy.Predict(
            "problem, explanation -> dinogsp_script: str"
        )
        # 第三步:出一道同類型的練習題
        self.make_exercise = dspy.Predict(
            "problem, key_concept, grade -> exercise: str, answer: str"
        )

    def forward(self, problem, grade):
        # 講解
        step1 = self.explain(problem=problem, grade=grade)
        # 生成圖形
        step2 = self.generate_diagram(
            problem=problem,
            explanation=step1.explanation
        )
        # 出練習題
        step3 = self.make_exercise(
            problem=problem,
            key_concept=step1.key_concept,
            grade=grade
        )
        return dspy.Prediction(
            explanation=step1.explanation,
            dinogsp_script=step2.dinogsp_script,
            exercise=step3.exercise,
            answer=step3.answer
        )
整條三步 pipeline 沒有手寫任何 prompt,寫的全部都是邏輯結構。
DSPy 內建幾個常見的推理策略模組:
| 模組 | 對應方式 | 在教學中的應用 |
|---|---|---|
dspy.Predict | 直接預測 | 題目難度分級、知識點標註 |
dspy.ChainOfThought | 鏈式思維 | 分步驟解題講解 |
dspy.ReAct | 思考-行動循環 | 呼叫外部工具驗證腳本 |
dspy.ProgramOfThought | 程式化思維 | 生成可執行的數學計算程式碼 |
3. Optimizer:自動調優引擎
這是 DSPy 最有辨識度的部分。
你只需要提供:
- 一個評估資料集,例如 100 道題和對應的人工作答樣本。
- 一個評估指標函式,用來判斷輸出是否足夠好。
之後呼叫最佳化器,它會自動搜尋更好的 prompt 指令與 few-shot 範例組合:
# 定義評估指標:講解是否適齡、圖形腳本是否能被解析
def lesson_quality_metric(example, prediction, trace=None):
    explanation_ok = len(prediction.explanation) > 50  # 基本長度
    script_parseable = validate_dinogsp(prediction.dinogsp_script)  # 腳本可用
    grade_appropriate = check_vocabulary_level(
        prediction.explanation, example.grade
    )  # 用詞適齡
    return explanation_ok and script_parseable and grade_appropriate

# 用 MIPROv2 進行優化
optimizer = dspy.MIPROv2(metric=lesson_quality_metric, auto="medium")
optimized_pipeline = optimizer.compile(
    MathLessonPipeline(),
    trainset=annotated_lessons
)

# 保存結果,生產環境直接載入,不需要重新優化
optimized_pipeline.save("./optimized_math_lesson.json")
一次 medium 級優化會有一定時間和成本,但換來的是一套針對指定模型、指定資料、指定指標自動調整過的內容生成系統。
看看資料
DSPy 官方有一組很讓人印象深刻的數據。
在 HotPotQA 多跳推理任務上,用 dspy.ReAct 搭配 gpt mini 系列:
- 優化前約 24% 準確率。
- 用 MIPROv2 在 500 個樣本上優化後,提升到約 51%。
重點不是換了更貴的模型,而是讓同一個模型更會做這類任務。
它和 LangChain / LlamaIndex 的本質差異
很多人會問:如果已經在用 LangChain,還需要 DSPy 嗎?
LangChain / LlamaIndex 更像工具鏈編排框架。它們擅長把 LLM、向量資料庫、工具呼叫等元件串起來,但 prompt 本身往往還是人手寫的字串。換模型時,很多時候還是得自己回去改 prompt。
DSPy 更像 AI 程式編譯框架。它不只負責串接元件,也嘗試接管 prompt 的生成與優化。開發者主要寫邏輯,而 DSPy 負責把這些邏輯翻譯成對特定模型更有效的自然語言指令。
放到數學教學場景裡會更直觀:
- 如果你用 LangChain 做了一套「三年級講解」pipeline,明天要支持五年級,通常還是得回頭手改 prompt。
- 如果你用 DSPy,更多時候改的是輸入條件和訓練集,然後重新 compile,讓框架替新的目標搜尋更合適的提示策略。
如果一定要打比方,LangChain 比較像自動化流水線,DSPy 比較像帶編譯器的高階語言。
我的開發者視角:它解決了什麼,還差什麼
DSPy 真正解決的問題
- 模型遷移的痛苦:從 GPT-5.4 換到更便宜的模型時,不需要手改所有 prompt,可以重新 compile。
- 多步驟聯合優化:講解品質和圖形腳本可用性這兩個目標,以前很難一起調,DSPy 可以把它們放進同一個優化過程。
- 實驗可重現:優化結果可以存成 JSON,方便團隊共享與版本管理。
目前的侷限
- 評估指標最難寫:像
validate_dinogsp()這樣的函式必須自己定義,而且要寫得夠嚴格,否則優化器很容易鑽漏洞。 - 優化不是免費的:資料量、模型單價與優化輪數疊加後,成本會明顯上升。
- 除錯體驗仍在成熟中:如果優化後表現仍不理想,通常很難立刻判斷問題是資料、指標,還是模型能力邊界。
什麼時候應該用 DSPy?
適合的場景
- 你在做多步驟的 LLM pipeline。
- 你需要在不同模型之間切換或遷移。
- 你有評估資料集,而且效果目標可以量化。
- 你受夠了靠感覺手調 prompt。
- 你需要長期維護一個生產級 AI 系統。
不太適合的場景
- 只是快速驗證一個 idea。
- 任務沒有清楚指標,沒辦法給最佳化器穩定回饋。
寫在最後
我覺得 DSPy 最值得重視的,不只是它能自動調 prompt,而是它提出了一種更可靠的工程思維:
AI pipeline 裡的 prompt,本質上更像程式參數,而不是程式原始碼。
就像我們不會把神經網路權重硬編碼進原始檔一樣,也不應該把某個模型剛好調順的 prompt 當成穩定邏輯本身。這些 prompt 更適合作為可學習、可優化、可保存、可遷移的產物。
教學內容的邏輯是穩定的,例如分步驟、有圖示、適齡表達;但如何引導模型做到這些,會隨著模型更新、年級擴張、題型增加而持續變動。DSPy 把兩者拆開,才讓 AI 教學系統真正具備可維護性。
如果你也在做 AI 教育、內容生成或多步驟 Agent pipeline,這個思路值得認真看一眼。