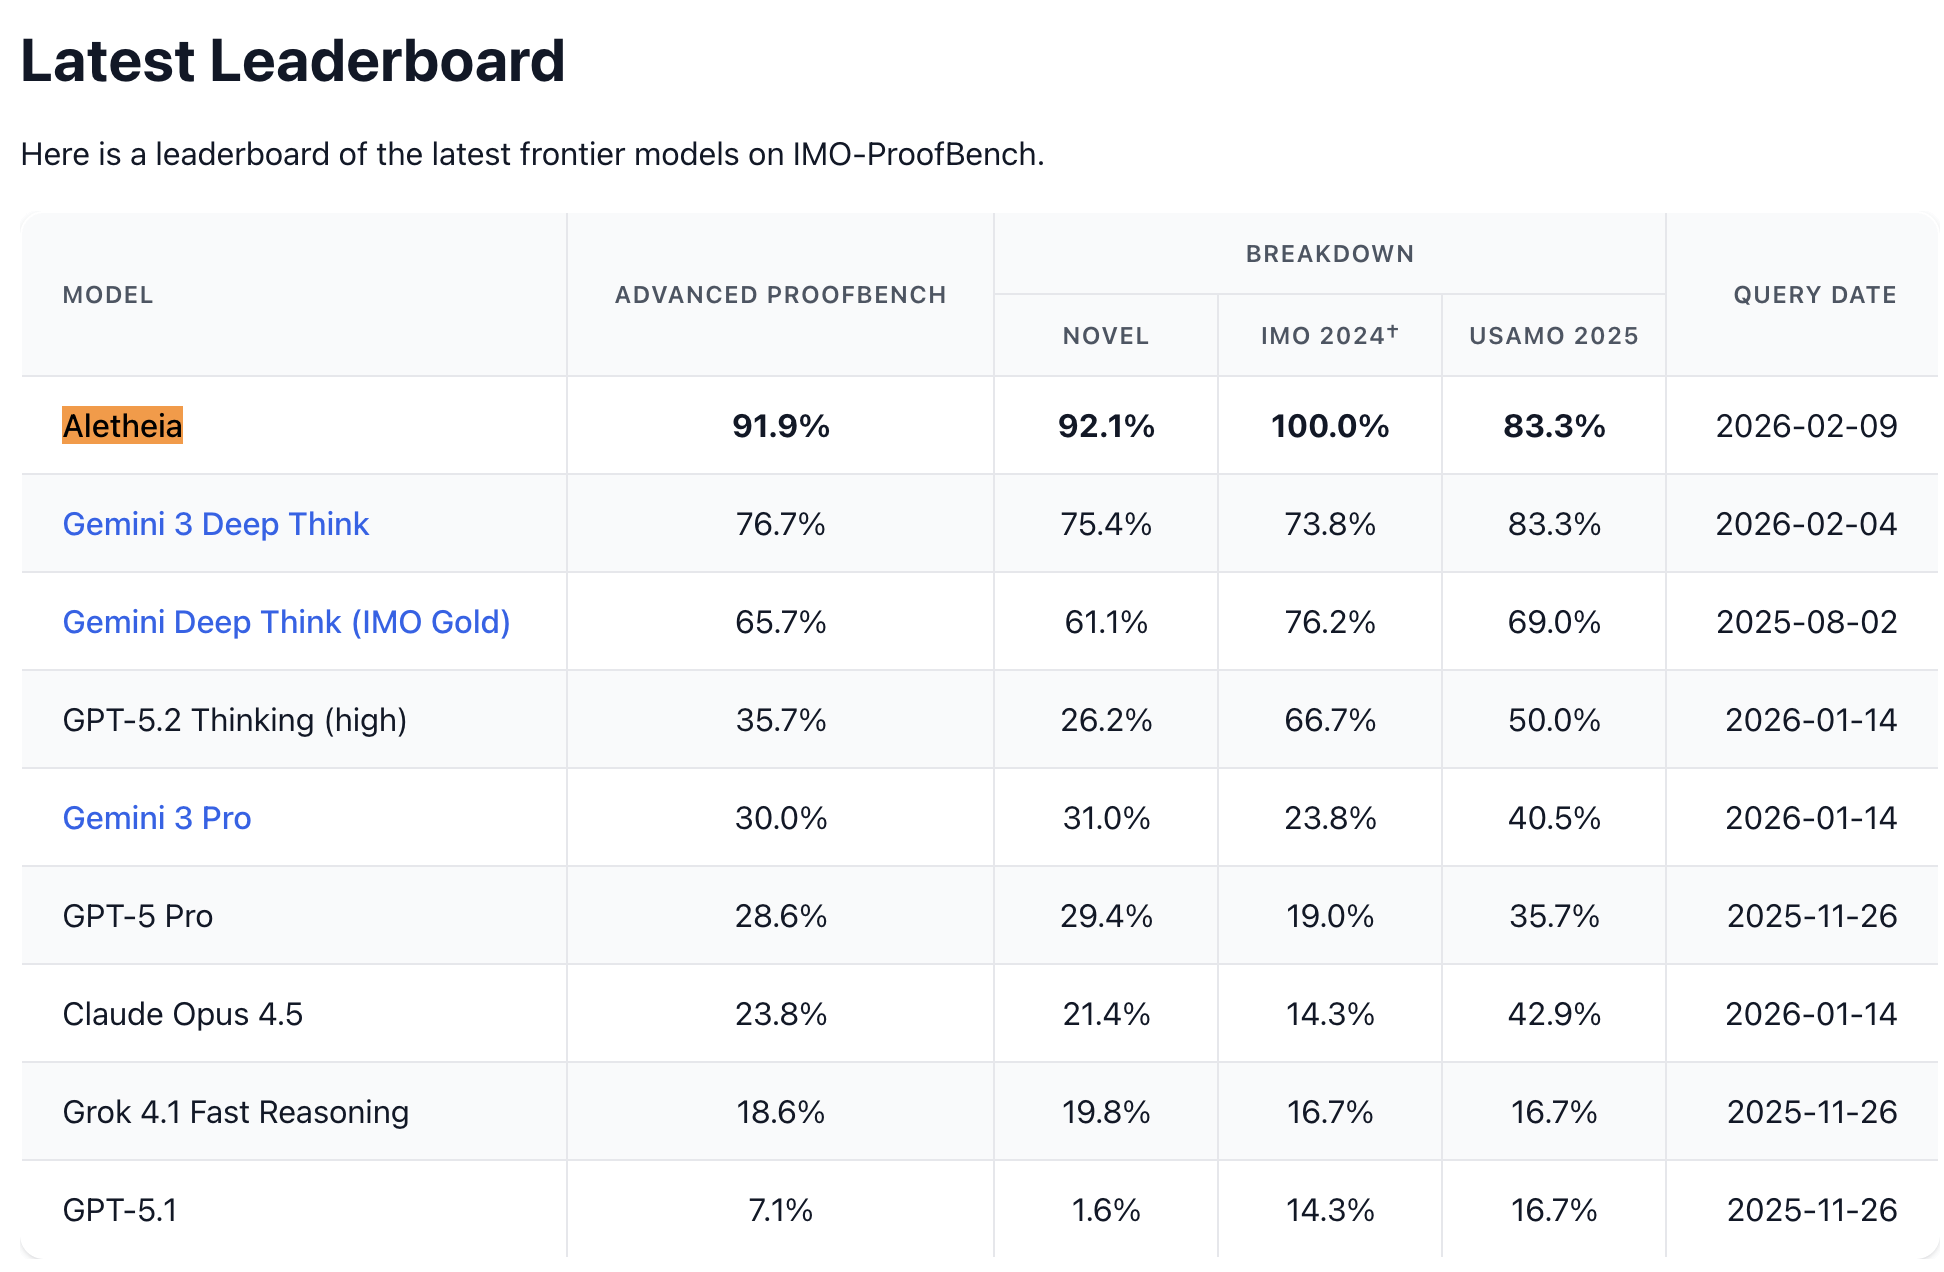
Google DeepMind Aletheia lidera el benchmark IMO-ProofBench Advanced con una puntuación impresionante de ~91.9%.
También supera de forma significativa a los sistemas base en problemas difíciles del USAMO 2025. En benchmarks internos más exigentes, también está por encima de modelos de razonamiento anteriores; aunque todavía existen brechas, va claramente por delante de las líneas base previas.
Las discusiones recientes sobre Aletheia resultan familiares.
Los titulares dicen “matemático de IA”, y en los comentarios preguntan: “¿va a reemplazar a los matemáticos? ¿ya puede hacer investigación autónoma?”
Revisé con cuidado el paper y el dataset de Aletheia, y luego organicé la arquitectura clave y las implicaciones prácticas que encontré. De eso trata exactamente este ensayo.
1) El camino hacia DeepMind Aletheia
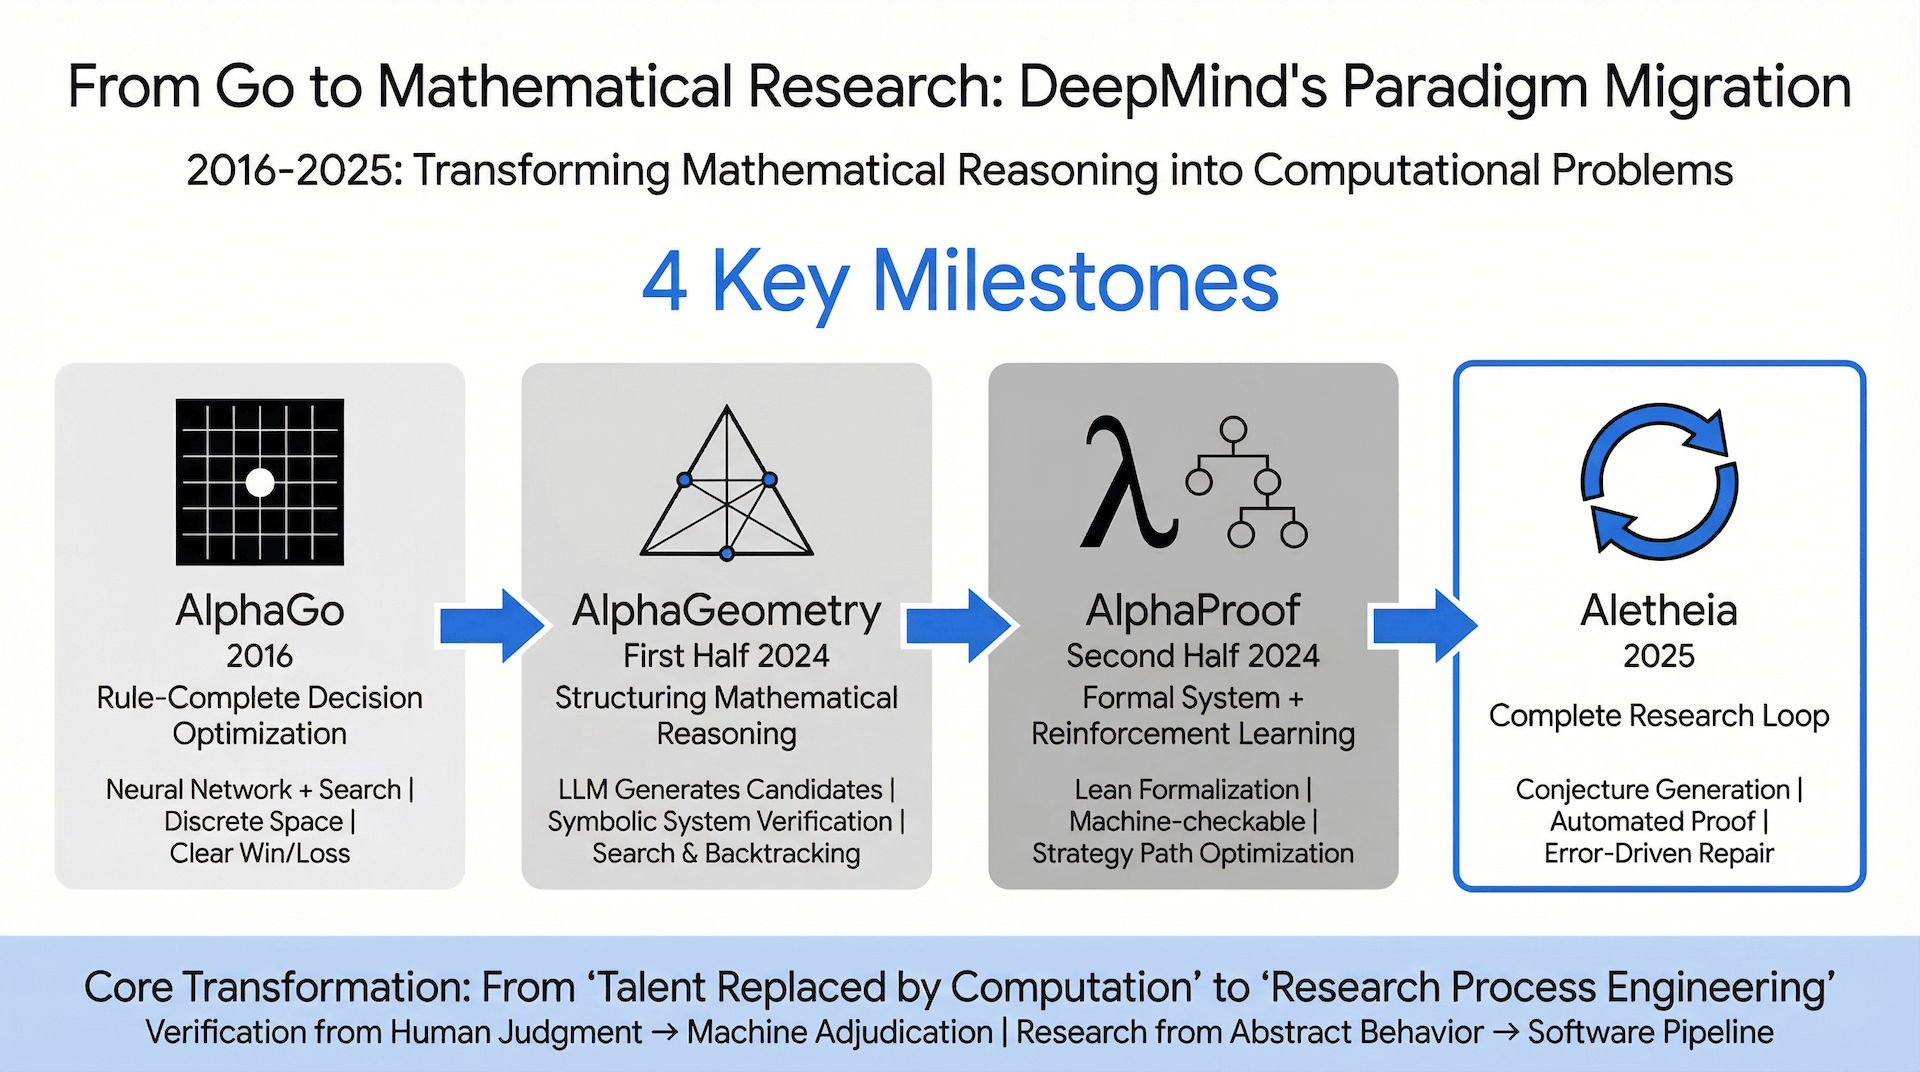
Al ver la línea de tiempo, está claro que Google DeepMind llevaba mucho tiempo construyendo en esta dirección.
Cuando apareció AlphaGo en 2016, la pregunta de fondo ya estaba allí: ¿cómo optimizar trayectorias de decisión dentro de un sistema con reglas completas y una función de evaluación clara?
Un juego de tablero es discreto, los resultados son decidibles y el espacio de búsqueda es enorme pero estructurado. Ese es un entorno ideal para optimizar estrategias.
El enfoque de DeepMind de “redes neuronales + búsqueda” nunca fue solo sobre Go. Estaba probando una hipótesis más amplia: si un problema puede describirse de forma estricta y cada paso puede juzgarse como correcto o incorrecto, parte del “talento” puede reemplazarse por cómputo.
Con AlphaGeometry en 2024, la pregunta cambió: ¿puede el razonamiento matemático colocarse también dentro de un sistema cerrado por reglas como este?
Diseño clave de AlphaGeometry:
- Un LLM propone candidatos de construcciones auxiliares
- Un sistema geométrico simbólico verifica restricciones
- La búsqueda gestiona retroceso y expansión
Por primera vez en este contexto, el LLM no decide la verdad; propone posibilidades, y los sistemas estructurales garantizan la validez lógica.
Esa transición importa: Google ya había comenzado a colocar el razonamiento matemático dentro de un bucle verificable.
A finales de 2024, AlphaProof movió el campo de batalla a sistemas formales como Lean. La pregunta pasó a ser: si la geometría puede estructurarse, ¿puede toda la matemática formalizarse a nivel de máquina?
Al entrar en sistemas tipo Lean, AlphaProof reduce de forma drástica el espacio de expresión:
- cada paso debe ser verificable por máquina,
- el sistema de tipos impone restricciones fuertes,
- el lenguaje ambiguo deja de servir,
- las pruebas no son “plausibles”; deben pasar verificación.
También añade aprendizaje por refuerzo para optimizar rutas de estrategia, de modo que el sistema no solo escribe pruebas; también aprende selección de tácticas, descomposición de objetivos y estimación del valor de ramas.
Desde este punto, la dirección de DeepMind se vuelve explícita: convertir el comportamiento matemático en un problema de búsqueda planificable.
Aletheia es la continuación de ese camino y, por ahora, su resultado más sólido.
2) Qué vale realmente la pena discutir sobre Aletheia
Decir “puede proponer y demostrar conjeturas de forma autónoma” todavía es demasiado superficial.
El núcleo más difícil de Aletheia tiene tres partes: bucle cerrado, estructura y planificación.
Si ese bucle funciona de forma estable, la investigación matemática realmente empieza a salir de las escalas temporales puramente humanas.
2.1 De verdad construyó un bucle de investigación ejecutable
La mayoría de sistemas de “IA matemática” siguen en el patrón entrada de problema -> salida de respuesta.
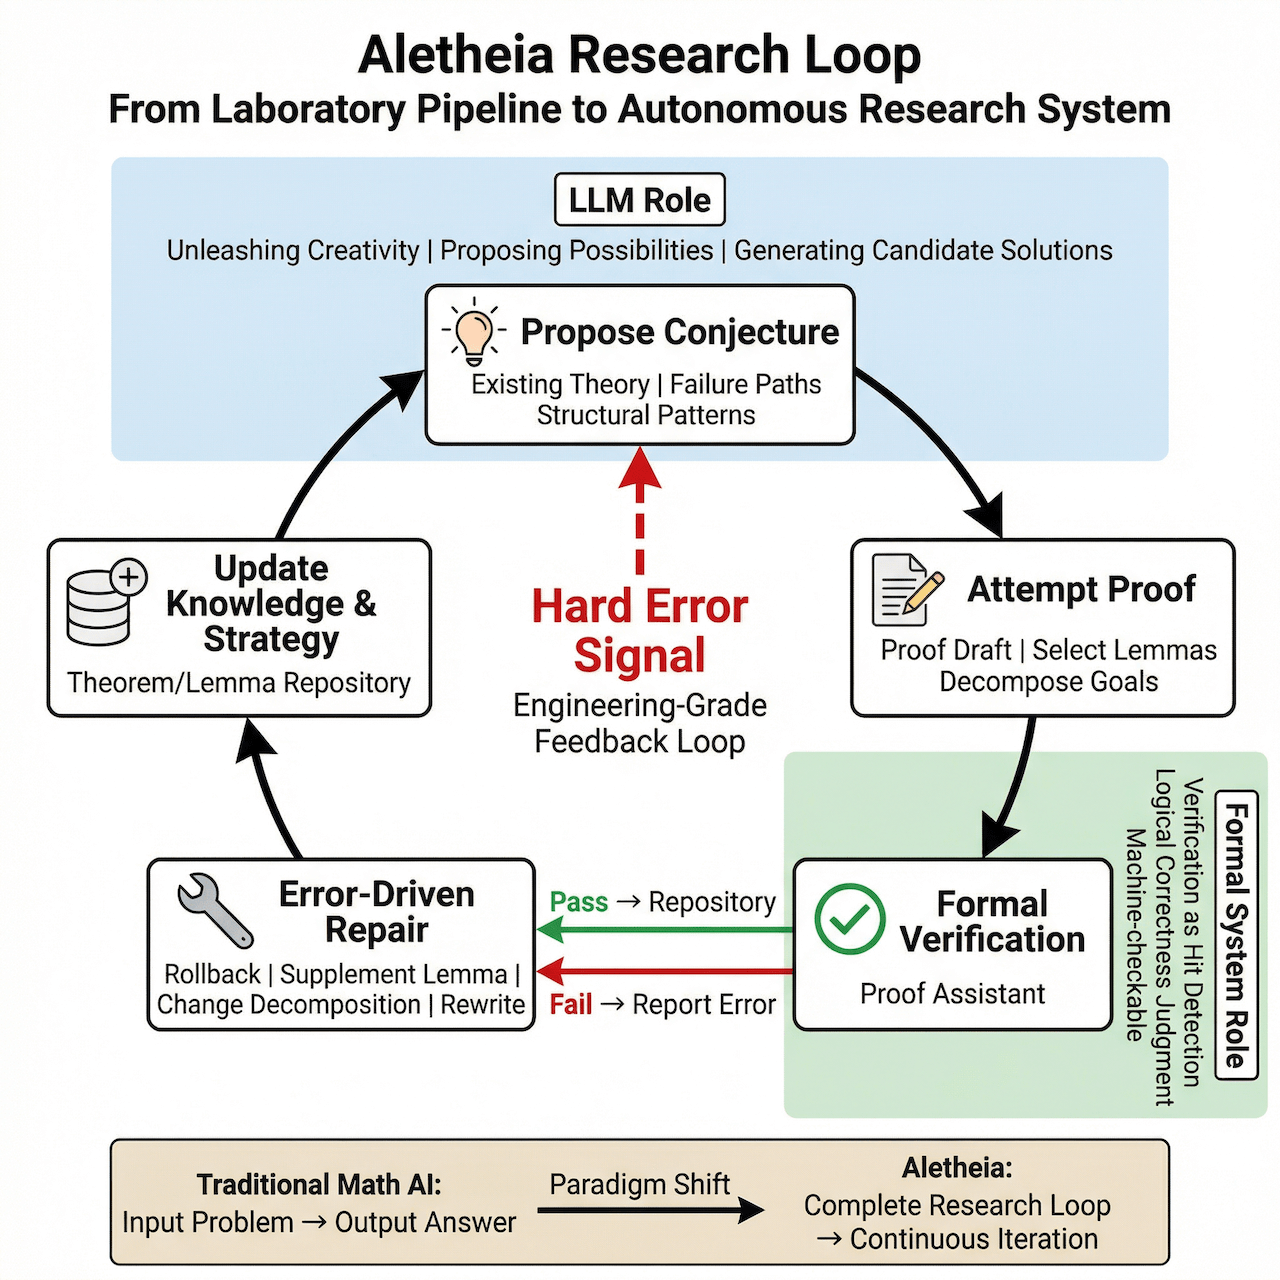
Aletheia se parece más a un pipeline de laboratorio. Un bucle mínimo se ve así:
- Propuesta de conjeturas: generar enunciados a partir de teoría existente, rutas fallidas o patrones estructurales
- Intento de prueba: generar borradores, elegir lemas, descomponer objetivos
- Verificación formal: enviar a un asistente de pruebas; los resultados aceptados se almacenan, los fallos devuelven errores duros
- Reparación guiada por errores: rollback, añadir lemas, cambiar descomposiciones, reescribir conjeturas
- Actualización de conocimiento/estrategia: retroalimentar al sistema con nuevos teoremas/lemas probados para la siguiente ronda de generación/búsqueda
La clave es que el fallo no es “baja calidad”; es una señal de error dura. Eso hace que el bucle de retroalimentación sea de nivel ingenieril.
Puedes verlo así: el LLM sirve para la generación creativa de candidatos, mientras que los sistemas formales deciden si algo realmente da en el blanco.
2.2 El núcleo no es el modelo; es la IR y las interfaces de verificación
Cuando la gente ve un nuevo resultado SOTA en matemáticas, la reacción por defecto suele ser “otra vez un modelo más grande y más fuerte”.
Pero en matemáticas formales, el techo del sistema suele depender menos del número de parámetros y más de la representación: cómo codificas un teorema o un estado de prueba, cómo mapeas “ideas” a árboles sintácticos verificables y cómo conviertes la retroalimentación del asistente de pruebas en señales aprendibles.
En ese sentido, Aletheia se parece más a un stack de “compilador matemático + depurador + motor de búsqueda”.
Eso requiere una capa intermedia pesada:
- Theorem Graph / Lemma Graph: grafo de dependencias entre resultados
- Representación del estado objetivo: codificación estructurada del estado actual de prueba (objetivo, hipótesis, restricciones de tipo)
- Representación de táctica/paso: espacio de acciones ejecutables para demostrar (similar a los espacios de acción de AlphaProof)
Sin esto, incluso un modelo potente solo puede producir “pruebas estilo ensayo” que no aterrizan en sistemas formales.
2.3 Por qué el significado ingenieril es mayor que la puntuación
Las puntuaciones son resultados. El valor ingenieril es método reutilizable.
Si Aletheia realmente tiene esas tres capas, entonces:
- la investigación matemática puede descomponerse en el paradigma espacio de acciones + retroalimentación + optimización de política,
- los sistemas formales mueven la corrección desde revisión humana hacia adjudicación de máquina,
- los LLM pasan de juez a generador de candidatos, reduciendo el radio de impacto de las alucinaciones.
El valor de esta ruta es que convierte “investigar” de un proceso humano abstracto en algo que los sistemas de software pueden implementar.
Dicho de otro modo: le da a la investigación un sabor de pipeline tipo CI/CD: proponer, verificar, fallar, reparar, fusionar.
3) ¿Qué pasa después de que el comportamiento de investigación se vuelve ingeniería?
Un cuello de botella histórico en matemáticas es el costo de verificación.
Las pruebas complejas pueden tardar meses o años en confirmarse por pares. El tiempo de revisión humana es escaso.
Los sistemas formales trasladan la corrección del juicio humano al juicio de máquina. Una vez que la verificación deja de ser el cuello de botella, la velocidad de generación se vuelve la variable principal.
Imagina un sistema que expande grafos de teoremas cada día, produce grandes volúmenes de lemas intermedios y reorganiza dependencias de forma continua.
Puede que no resuelva de inmediato los grandes problemas abiertos, pero seguirá rellenando espacio teórico.
¿Qué cambia cuando la producción de investigación escala?
Mi apuesta: primero, el ritmo.
El ritmo del campo ha estado limitado durante mucho tiempo por la capacidad humana de verificación. Si la verificación pasa a estar gestionada por máquinas, la velocidad de expansión teórica aumentará con fuerza. Entonces el recurso escaso ya no será la capacidad de demostrar, sino la selección de problemas y la organización de teoría.
Cuando la velocidad de generación de proposiciones supera la velocidad de lectura humana, el ritmo disciplinar se rompe.
Notas finales
Si también trabajas en educación + IA, tengo bastante confianza en esto: los productos de IA puramente textuales de “explicación de soluciones” serán cada vez más difíciles de sostener.
A medida que se integren sistemas formales y se estandarice la verificación, los productos que solo explican pasos quedarán desplazados hacia los márgenes.
La defensibilidad futura probablemente exigirá tres cosas:
- Una capa intermedia estructural: no solo salida de texto, sino objetos ejecutables
- Verificación integrada: chequeo por máquina como capacidad por defecto
- Soporte para modo de exploración: permitir que estudiantes propongan conjeturas, prueben hipótesis y observen retroalimentación de fallos
Los sistemas de enseñanza se parecerán cada vez más a pequeños entornos de teoremas, no a bots de chat únicamente.
Este camino no es fácil. Probablemente exige, al menos, capacidades de DSL o representación formal, además de sistemas de restricciones ejecutables e interfaces con motores de prueba/verificación.
Pero si la dirección de Aletheia continúa, esto probablemente sea una tendencia de largo plazo.
Lecturas adicionales
- Google DeepMind. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Official Blog Post, 2026.
- Google DeepMind. AlphaGeometry: An Olympiad-Level AI System for Geometry. Official Blog Post, 2024.
- Google DeepMind. Towards Autonomous Mathematical Research. arXiv preprint, 2026.