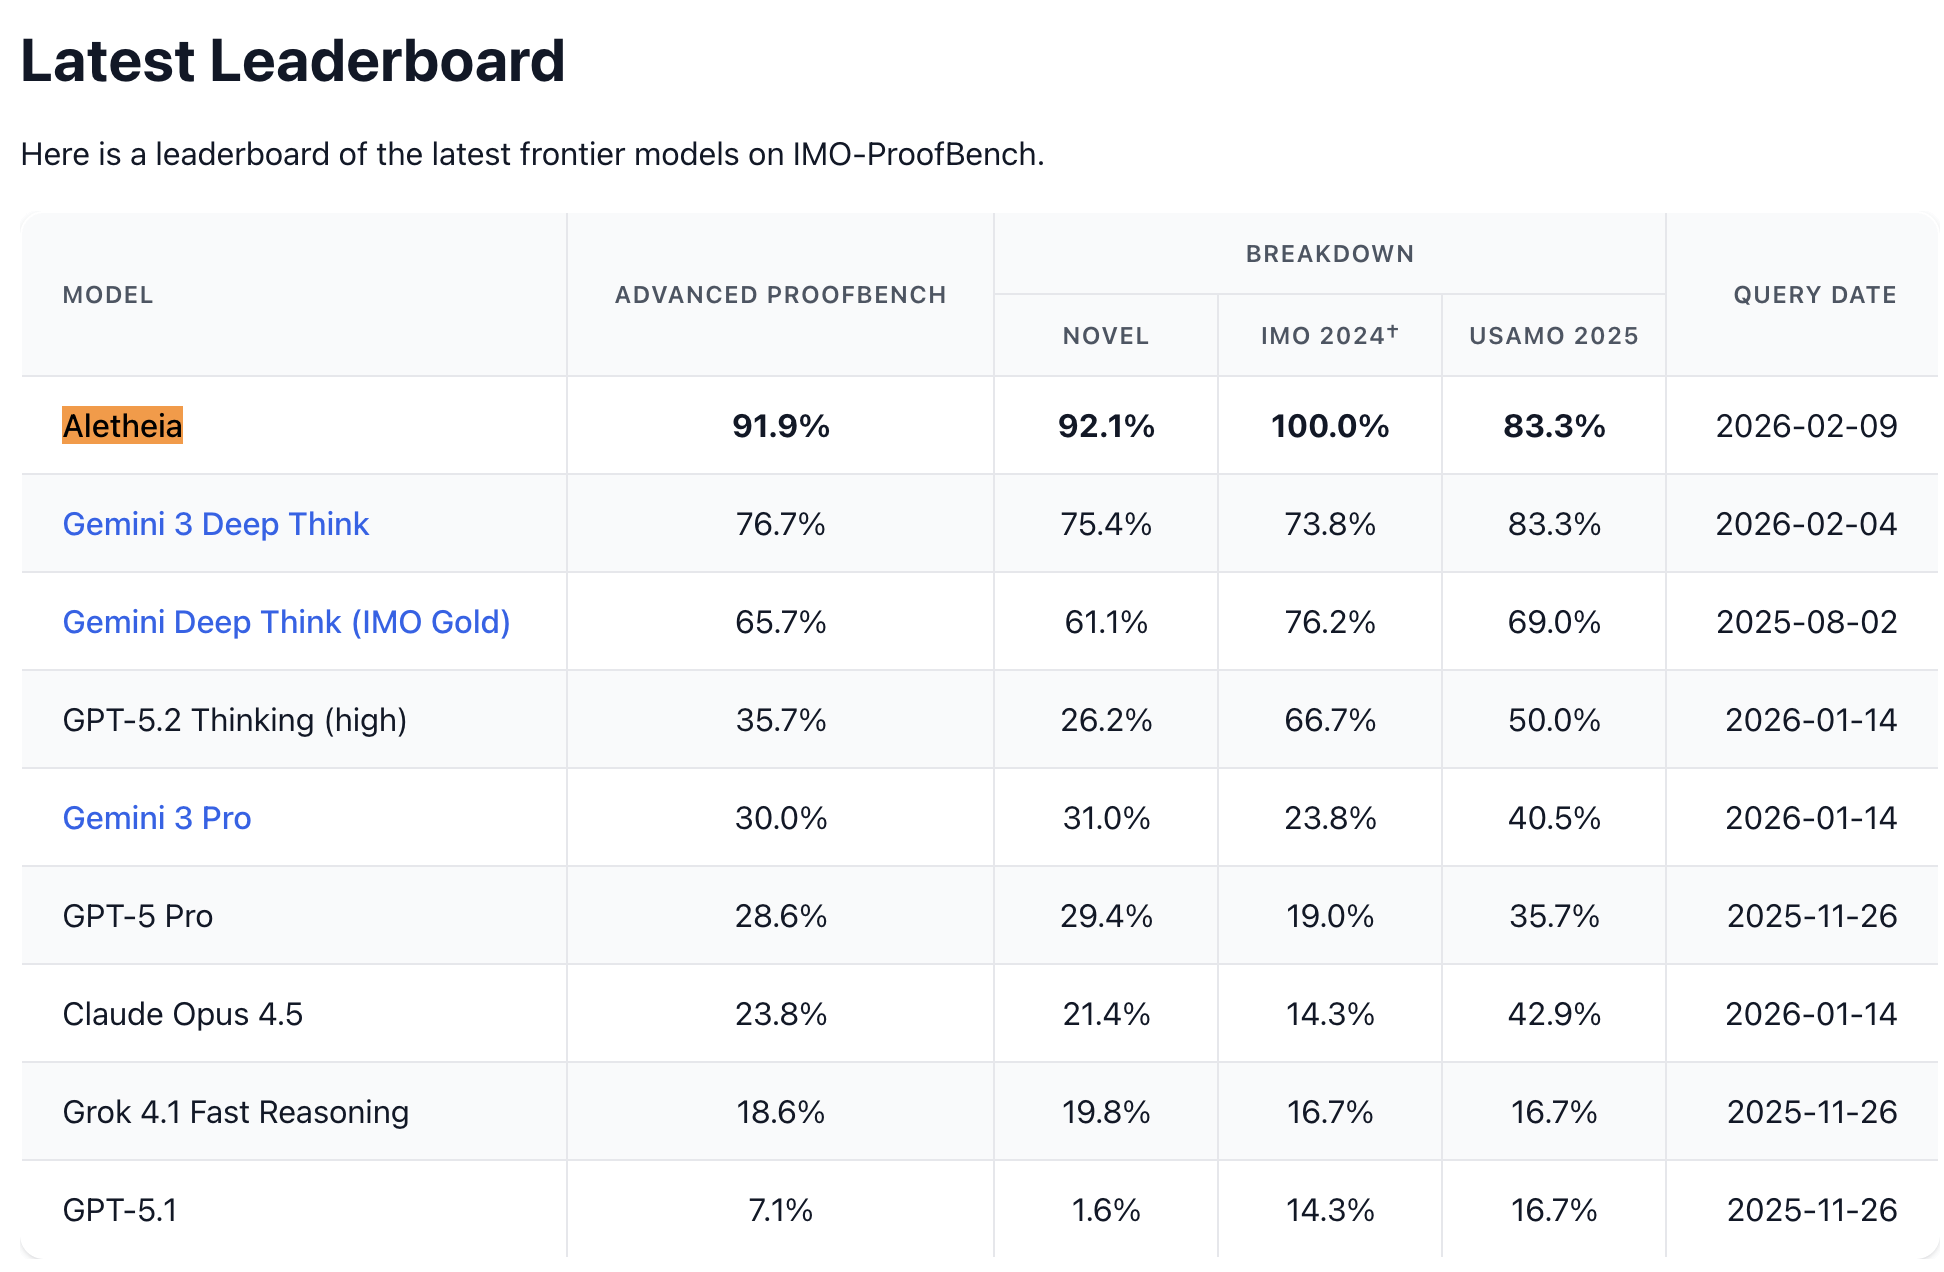
Google DeepMind Aletheia 在 IMO-ProofBench Advanced 資料集中以 ~91.9% 成績遙遙領先。
針對美國數學奧林匹克 2025 難題的表現也遠超基線系統。在內部更難的 benchmark 上表現超過舊版推理模型,雖仍有差異但已領先過去基線。

最近關於 Aletheia 的討論,有點熟悉的味道。
標題裡寫著「AI 數學家」,留言區在問「是不是要取代數學家了?是不是已經能自動搞科研了?」
我認真研究了 Aletheia 的論文和資料集,把我學到的關鍵架構與落地價值整理出來,也就是本文的內容。
一、DeepMind Aletheia 的來時路
把時間線拉長看,會發現 Google DeepMind 在這個方向上已經蓄力很久了。
在 2016 年推出 AlphaGo 時,就已經開始研究一個問題:如何在一個規則完備、評價函數明確的系統裡,優化決策路徑?
棋盤是離散的,勝負可判定,搜尋空間巨大但結構清晰,那是一種理想的策略優化環境。
DeepMind 那套「神經網路 + 搜尋」的方法,從一開始也不是為了圍棋。它在嘗試驗證一個想法 —— 如果一個問題能被嚴格描述、每一步都能被判斷對錯,那「天賦」就可以用計算替代。
到了 2024 年發布的 AlphaGeometry,問題變成了 —— 數學推理是否也能被放進這種規則封閉系統?
AlphaGeometry 的關鍵設計在於:
- LLM 生成輔助線候選
- 符號幾何系統進行約束驗證
- 搜尋機制進行回溯與擴展
這裡第一次看到在數學推理這個場景下,LLM 不負責判斷對錯,而是負責提出可能性,真正的邏輯正確性由結構系統兜底。
這個節點非常重要,因為 Google 已經開始把數學推理放到一個可驗證的循環裡了。
2024 下半年的 AlphaProof 則把戰場搬進 Lean 等形式系統,問題變成了 —— 如果幾何可以結構化,那整個數學是否可以形式化到機器級別?
AlphaProof 進入 Lean 等形式系統,徹底收緊表達空間:
- 每一步推理必須 machine-checkable
- 型別系統強約束
- 模糊語言徹底失效
- 證明不再「看起來合理」,而是必須通過驗證
同時引入強化學習優化策略路徑,使系統不只是會寫證明,而是學會選擇 tactic、分解目標、評估分支價值。
從這一步開始,DeepMind 在做的事情越來越清晰:把數學行為變成一個可以調度的搜尋問題。
Aletheia 正是這個路徑的延伸,也取得了當前最亮眼的成績。

二、Aletheia 真正值得討論的地方
如果只說它能自主提出 conjecture 並證明,還是太輕了。
Aletheia 最硬的點有三個:閉環、結構、調度。
如果這個閉環真的穩定運行,那數學研究將真正脫離人類的時間尺度。
1. 它真正做成的,是一個能跑起來的研究閉環
大多數「數學 AI」系統,本質是輸入題目 → 輸出答案。
Aletheia 更像一條實驗室管線,把它拆開看,最小閉環大概長這樣:
- 提出猜想:從既有理論、失敗路徑、或結構模式中產生命題
- 嘗試證明:生成證明草稿、選擇引理、分解目標
- 形式化校驗:進 proof assistant,能過就入庫,過不了就報錯
- 錯誤驅動修復:根據報錯回滾、補 lemma、換分解方式、重寫 conjecture
- 更新知識與策略:把新產出的 theorem / lemma 加回系統,影響下一輪生成與搜尋
這裡最關鍵的是,失敗不是答得不好,而是硬錯誤訊號。這讓系統有了工程上真正可用的回饋回路。
你可以把它理解成 LLM 負責亂槍打鳥的創造力,形式系統負責槍響之後到底有沒有打中。

2. Aletheia 的核心不是模型,是中間表示(IR)與驗證介面
很多人看見數學評測刷新高分,第一反應是:又是更大更強的模型。
但在 formal math 裡,決定系統上限的往往不是參數量,而是你怎麼表示一個定理、一個證明狀態?你怎麼把「想法」落到可檢查的語法樹上?你怎麼把 proof assistant 的回饋變成可學習訊號?
換句話說,Aletheia 更像一個「數學版編譯器 + 除錯器 + 搜尋器」的組合體。
這裡面至少要有一個很重的中間層:
- Theorem Graph / Lemma Graph:定理與引理的依賴關係圖
- Goal State 表示:當前 proof state 的結構化描述(目標、假設、型別約束)
- Tactic / Step 表示:可執行的證明動作空間(類似 AlphaProof 的 action space)
否則它再聰明也只能「寫作文式證明」,落不了地。
3. 為什麼說它工程意義大於成績意義
成績只是結果,工程意義是可複用的方法。
Aletheia 如果真的具備上述三層能力,意味著:
- 數學研究可以被拆成「動作空間 + 回饋 + 策略優化」的範式
- 形式系統把正確性從「人類評審」變成「機器裁決」
- LLM 從裁判退到「候選生成器」,減少幻覺的破壞半徑
這條路線的價值在於,它把「研究」從一個抽象的人類行為,落實到一個能被軟體系統實現的過程。
換句話說,它讓「科研」這件事開始有了像 CI/CD 一樣的流水線味道——提出、驗證、失敗、修復、合併。
三、研究行為被工程化之後,會發生什麼?
過去數學界的瓶頸之一,是驗證成本。
一個複雜證明要花數月甚至數年被同行確認。人類評審的時間是稀缺資源。
形式系統把「正確性」從人類判斷,變成機器判斷。當驗證開始不再是瓶頸,生成速度就會成為主變數。
你可以想像一個系統,每天擴展定理圖、產出大量中間引理、自動整理依賴結構……
它未必立刻解決重大難題,但它會不斷填充理論空間。
規模化的研究輸出,會改變什麼?
我猜首先會改變節奏。
數學界的節奏長期建立在「人類驗證能力」之上。當驗證被機器託管,理論擴張的速度會明顯提高。 那時,真正稀缺的資源,不再是證明能力,而是選題能力與理論組織能力。
當命題生成速度超過人類閱讀速度時,學科的節奏會斷裂。
寫在最後
如果你也在做 教育 + AI 方向,我可以很確定地說:未來純文本解題型的 AI 產品,會越來越難以生存。
當形式系統接入、驗證能力標準化,只做「講解步驟」的產品會逐漸邊緣化。
未來有壁壘的產品,很可能具備三點:
- 結構中間層:不是只輸出文本,而是構造可執行物件
- 驗證能力內建:機器校驗成為預設功能
- 探索模式支援:允許學生提出 conjecture、測試假設、看到失敗回饋
教學系統會越來越像一個小型 theorem environment,而不是問答機器人。
不過這條路並不輕鬆,目前看來它要求產品至少具備 DSL 或形式化表達能力,加上可執行約束系統,還需要與證明器或驗證引擎的介面。
但如果 Aletheia 這種方向持續推進,這會成為長期趨勢。
延伸閱讀
- Google DeepMind. Accelerating Mathematical and Scientific Discovery with Gemini Deep Think. Official Blog Post, 2026.
- Google DeepMind. AlphaGeometry: An Olympiad-Level AI System for Geometry. Official Blog Post, 2024.
- Google DeepMind. Towards Autonomous Mathematical Research. arXiv preprint, 2026.