Ayer, un agente dedicó media hora a encontrar el comando correcto para ejecutar las pruebas. Hoy abre una sesión nueva y vuelve a intentar soluciones que ya habían fallado.
Un contexto más largo puede aliviar el problema. Pero los proyectos siguen cambiando y las sesiones siguen creciendo. El coste acaba siendo difícil de sostener.
Después de que un agente haga algo, ¿qué conserva realmente el sistema y cómo convierte ese recuerdo en ayuda útil para la próxima vez?
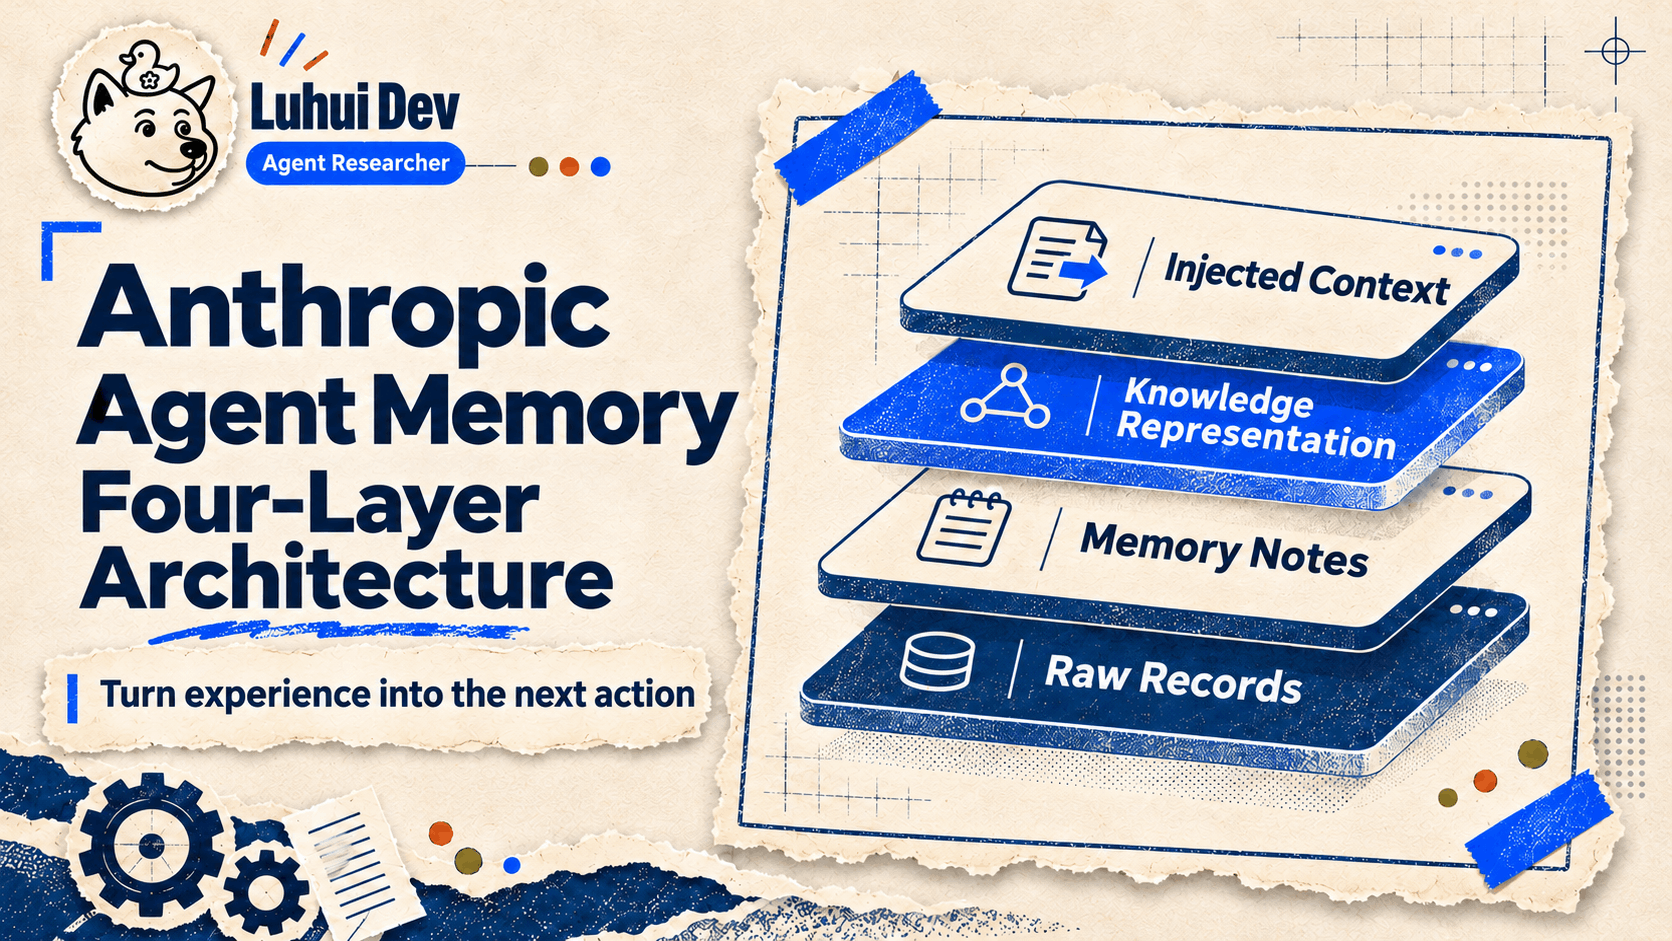
Al volver a estudiar la memoria de agentes de Anthropic, encontré cuatro responsabilidades fundamentales: conservar registros completos, extraer experiencia reutilizable, organizar el conocimiento disperso y ofrecer a la siguiente sesión un punto de partida breve.
Quiero descomponer esta estructura siguiendo el trabajo de un agente de programación.
Tres significados distintos de «recordar»
Supongamos que el usuario le dice al agente: «Este proyecto utiliza pnpm».
Si esa frase sigue visible en la conversación actual, la información está disponible en el contexto.
Si el sistema la escribe en un archivo persistente que otra sesión puede leer, hablamos de memoria externa.
Si el entrenamiento modifica los parámetros del modelo, se trata de otro mecanismo de aprendizaje.
Todos pueden hacer que el modelo parezca «saber» algo, pero requieren soluciones de ingeniería diferentes.
Para quienes desarrollan aplicaciones, la memoria externa permite inspeccionar el contenido, localizar su origen, actualizar conclusiones y deshacer una escritura incorrecta. Tiene un ciclo de vida que podemos gestionar.
También conviene distinguir la compactación de conversaciones. La compactación suele permitir que continúe la tarea actual, mientras que la memoria a largo plazo debe facilitar la reutilización entre tareas. Un resumen compactado puede aportar material para la memoria, pero guardarlo indefinidamente no resuelve por sí solo la caducidad, los conflictos ni cuándo recuperarlo.
Primero hay que decidir cuánto tiempo debe vivir la información; después, dónde guardarla.
Las cuatro capas de un vistazo
Según su función, la memoria de un agente puede organizarse en cuatro capas: registros originales, notas de memoria, representaciones del conocimiento y contexto inyectado. Conservan, respectivamente, la experiencia completa, las lecciones extraídas de ella, las relaciones organizadas entre conocimientos y la pequeña cantidad de información necesaria al comenzar cada sesión.
Son capas de organización de la información, no cuatro tipos de base de datos ni una secuencia obligatoria por la que deba pasar cada elemento.
Un mismo almacenamiento de archivos puede sostener varias capas. A la inversa, una capa puede apoyarse en varios sistemas de almacenamiento.
El contexto inyectado, situado arriba, suele generarse a partir de un archivo de entrada persistente o de elementos de memoria seleccionados. Se carga en la ventana de contexto del modelo al empezar la sesión.
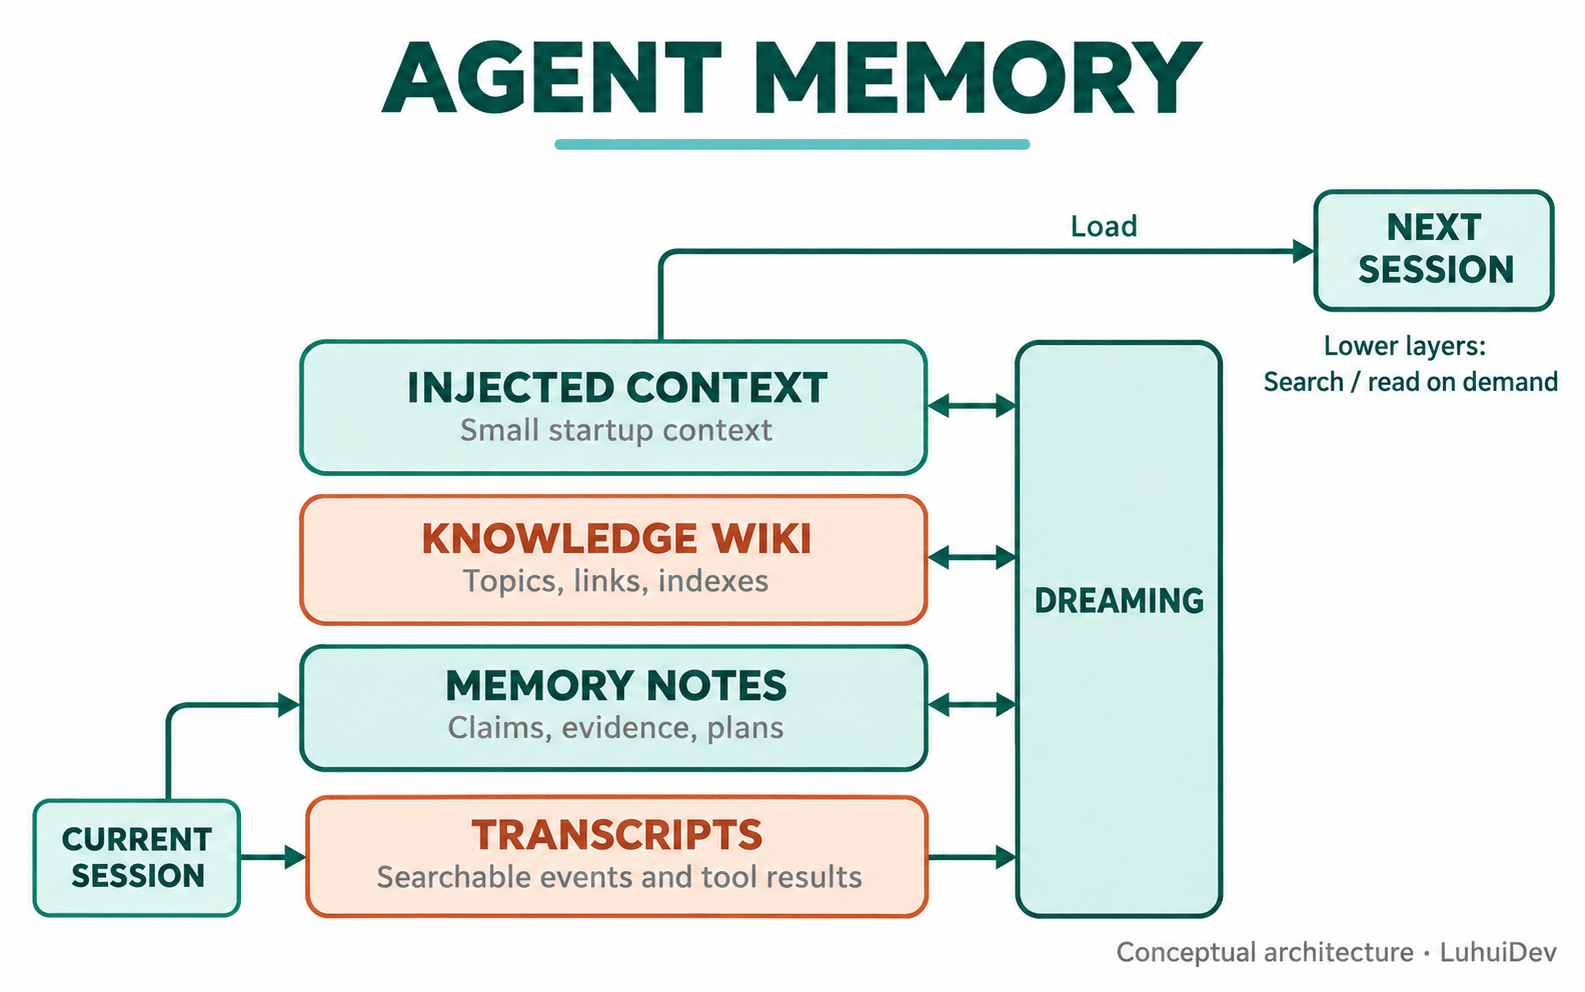
Comparar el contenido, la organización y el almacenamiento de cada capa ayuda a entender sus diferencias:
| Capa | Contenido | Organización habitual | Almacenamiento o soporte posible | Forma de lectura |
|---|---|---|---|---|
| Registros originales | Mensajes, llamadas a herramientas, resultados de ejecución y otros eventos | Registros cronológicos, flujos de eventos JSONL | Archivos de registro, tablas de eventos, almacenamiento de objetos | Búsqueda por evento, fecha o palabra clave |
| Notas de memoria | Lecciones, preferencias, planes y conclusiones con evidencia | Notas Markdown, entradas estructuradas | Directorios de archivos, registros en bases de datos | Recuperación dentro del ámbito de la tarea y lectura de detalles |
| Representaciones del conocimiento | Conocimiento temático, relaciones entre conceptos e índices | Páginas wiki, documentos enlazados, índices temáticos | Colecciones de documentos enlazados; opcionalmente, bases de datos de grafos | Navegación por tema, enlace o índice |
| Contexto inyectado | Convenciones frecuentes, avisos importantes y accesos a la memoria | Archivo de entrada breve, fragmentos seleccionados | Contenido persistente cargado en la ventana de contexto durante la ejecución | Carga automática al iniciar la sesión |
En un proyecto pequeño, basta un directorio de registros al que solo se añaden entradas, unas páginas temáticas en Markdown y un índice breve para experimentar con esta estructura.
Registros originales: conservar la evidencia
Tomemos tres eventos relacionados con un comando de pruebas:
E17: Ejecutar pnpm test. Falla porque la base de datos de pruebas no está disponible.
E18: Iniciar la base de datos de pruebas proporcionada por el proyecto.
E19: Ejecutar pnpm test de nuevo. Las pruebas pasan.
Un registro puede demostrar qué se observó en aquel momento. No garantiza que la explicación del agente sea correcta ni que el proyecto vaya a comportarse siempre igual. Conservarlo permite revisar las acciones y las respuestas concretas.
Si el registro también contiene la afirmación del agente «ante cualquier fallo de pruebas hay que reiniciar la base de datos», no debemos darle la misma fuerza probatoria por el mero hecho de estar escrita allí.
Sugiero que cada evento incluya, como mínimo, fecha y hora, proyecto, versión o identificador de commit, tipo de evento y ubicación del contenido. Las peticiones del usuario, las observaciones de herramientas y las inferencias del modelo deben poder distinguirse. Así, las capas superiores pueden volver a evidencia concreta en lugar de citarse entre sí dentro de un conjunto de textos.
Notas de memoria: convertir una experiencia en conocimiento condicionado
Los eventos anteriores permiten redactar una nota más prudente:
Con la configuración actual de pruebas del proyecto A, las pruebas de integración necesitan una base de datos de pruebas disponible. En la sesión 42, las pruebas pasaron después de iniciarla.
Frente al registro original, esta nota añade un ámbito de aplicación y conserva la base observacional.
En mi propia implementación, intento que cada entrada responda a cinco preguntas: ¿Cuál es la conclusión? ¿Dónde se aplica? ¿Dónde está la evidencia? ¿Cuándo se verificó? ¿Qué cambio la invalidaría?
Los campos pueden adaptarse a cada proyecto. Lo esencial es mantener el vínculo entre conclusión y evidencia. Tampoco hace falta mostrar todos los metadatos al modelo. El sistema puede filtrar primero por proyecto y versión, y enviar después solo el contenido necesario para la tarea actual.
La calidad de una entrada de memoria depende de si ayuda a actuar con fundamento más adelante.
Representaciones del conocimiento: evitar exploraciones repetidas
Cuando un proyecto acumula cientos de recuerdos, los nombres de archivo dejan de ser suficientes para saber qué leer. Podemos añadir páginas temáticas: una sobre pruebas enlaza la configuración de la base de datos; otra sobre publicación conecta el procedimiento de versiones, las condiciones de reversión y los registros de despliegue.
La búsqueda responde «¿Existe algo relevante?». Una página temática también explica «¿Cómo se relacionan estas cosas?».
Si el usuario pregunta «¿Por qué funciona en local y falla en CI?», las palabras utilizadas quizá no aparezcan en una nota concreta. Sin embargo, una página temática puede tener ya organizadas las diferencias entre entornos.
Al investigar un fallo de CI, esa página puede conectar primero las diferencias de entorno, las dependencias de la base de datos y las decisiones anteriores. Después, para una versión o un error específicos, la búsqueda permite localizar configuraciones y registros. Así evitamos reconstruirlo todo desde cero sin tratar la página temática como la totalidad de los hechos.
Mantener solo una wiki puede dejar fuera detalles. Depender únicamente de la búsqueda puede obligarnos a pagar repetidamente el coste de reconstruir relaciones. Ambas pueden combinarse para reducir rodeos durante la tarea.
Mi criterio es este: cuando las relaciones entre documentos se reutilizan con frecuencia, merece la pena organizarlas por adelantado. Para consultar un campo de forma ocasional, la búsqueda directa puede salir más barata. Organizar conocimiento también cuesta construirlo y mantenerlo.
Contexto inyectado: indicar al agente dónde buscar
Al comenzar una sesión, el agente todavía no sabe qué desconoce. Un punto de entrada breve puede indicarle dónde está el proyecto, qué convenciones importan y dónde leer los procedimientos de pruebas y publicación.
La memoria automática de Claude Code es un ejemplo: solo el comienzo de MEMORY.md se incorpora a la nueva sesión, mientras que los archivos temáticos detallados se leen cuando hacen falta. La entrada indica al agente qué recuerda y dónde encontrarlo; no necesita contener todo el conocimiento.
En mi sistema de pruebas, convertí esa entrada en una guía de navegación:
Proyecto actual: A
Entorno y comandos de pruebas: consultar testing.md
Publicación y condiciones de reversión: consultar release.md
Preferencias de escritura a largo plazo: consultar writing-preferences.md
Para decidir si inyectar un elemento, podemos considerar su frecuencia de uso, el coste de omitirlo y su longitud. Una regla poco frecuente cuya omisión resulte muy costosa puede merecer más espacio que una actualización de estado corriente que aparece a menudo.
Dreaming: mantener las transformaciones entre capas
Las cuatro capas dan al agente un lugar donde guardar experiencias y una ruta para recuperar conocimiento. La siguiente pregunta es: cuanto más tiempo trabajamos en el mismo proyecto, ¿puede el esfuerzo pasado facilitar la próxima tarea?
Los errores de ayer deberían poder evitarse hoy. Las pistas repartidas entre varias sesiones deberían reunirse en un juicio coherente. Los procedimientos que han cambiado deberían retirarse del punto de partida de la sesión. Entonces la memoria empieza a aportar un valor acumulativo.
Dreaming se ocupa de este trabajo en segundo plano. Durante la tarea, el agente concentra su atención en el problema inmediato. Fuera de ella, revisa experiencias, comprueba conclusiones y ajusta la estructura del conocimiento para que las sesiones posteriores encuentren información útil con más facilidad. La analogía con el sueño humano resulta natural.
Pero, al diseñarlo, descubrimos que «organizar» encierra muchas decisiones.
Si una lección aparece tres veces, ¿es un patrón o el mismo error repetido tres veces? Si un registro nuevo contradice una nota anterior, ¿ha cambiado el entorno o se aplican a proyectos distintos? Una conclusión puede merecer un lugar en las notas detalladas, pero ¿también debe cargarse antes de cada sesión?
Estas decisiones afectan a varias capas. Corregir una regla de pruebas puede exigir actualizar a la vez la nota de memoria, la página temática de pruebas y el índice inicial.
El valor de Dreaming está en mantener útil la experiencia. El reto de implementación consiste en que cada reorganización tenga evidencia, pueda verificarse y pueda revertirse si sale mal.
Por ahora, lo esencial es situarlo en la arquitectura: mantiene el contenido y las relaciones entre las capas para preparar una memoria más fiable para futuras tareas. Elegir las entradas, resolver conflictos, comprobar conclusiones y escribir los cambios de forma segura merece una explicación aparte, que continuaré en un próximo artículo sobre Anthropic Dreaming.
Reflexiones finales
Prefiero mantener la memoria de un agente como un activo de software. Tiene fuentes, un ámbito de aplicación y un periodo de validez. Cuanto más se acumula, más necesario resulta gestionar su deuda técnica.
Los registros permiten revisar la experiencia; las notas, reutilizar las lecciones; la organización del conocimiento, encontrar relaciones; y una entrada breve indica a la siguiente sesión dónde empezar. La organización en segundo plano corrige continuamente estos materiales.
El valor de la memoria debe materializarse, al final, en las tareas futuras.