一个 Agent 昨天花了半小时找到正确的测试命令,今天换个新会话,又开始尝试昨天已经失败过的方案。
给它更长的上下文,倒是能缓解这个问题。但项目会持续变化,会话会继续增长,这个成本也实在吃不住。
到底 Agent 做过一件事以后,系统究竟留下了什么,下一次又如何把它变成有效帮助?
正好趁此机会重新学习理解 Anthropic 的 Agent Memory,发现架构中最关键的四件事:留下完整记录,提炼可复用的经验,把分散知识组织起来,给下一次会话一个简短的开工入口。
我想沿着一个编码 Agent 的工作过程,把这套结构拆开看看。
先把三种“记住了”分清楚
假设用户告诉 Agent:“这个项目使用 pnpm。”
当前对话还能看到这句话,属于当前上下文可用。
系统把它写入持久文件,下次会话还能读到,属于外部记忆。
模型经过训练,参数发生变化,则是另一种学习机制。
这几种机制都可能让模型表现出“知道了”,却需要不同的工程手段。
对应用开发者来说,外部记忆意味着我们可以检查内容、找到来源、更新结论,也可以撤销一次错误写入。它有可操作的生命周期。
同样需要区分的是对话压缩。压缩通常服务于当前任务继续运行,长期记忆则要考虑跨任务复用。压缩摘要可以成为记忆的材料,但把摘要长期保存,并不能自动解决过期、冲突和读取时机。
所以我们需要先明确信息要活多久,再决定它应该住在哪里。
四层架构:一图看懂
Agent Memory 可以按信息的用途分成四层:原始记录、记忆笔记、知识表示和注入上下文。它们分别保存完整经历、从经历中提炼的经验、组织好的知识关系,以及每次会话开始前需要知道的少量信息。
这里的“层”是信息的组织层次,不是四种数据库,也不是每条信息都必须依次经过的流水线。
同一份文件存储就能承载多层内容;反过来,一层也可以由多种存储共同支撑。
尤其是最上面的注入上下文,它通常由持久保存的入口文件或记忆条目生成,在会话开始时加载进模型的上下文窗口。
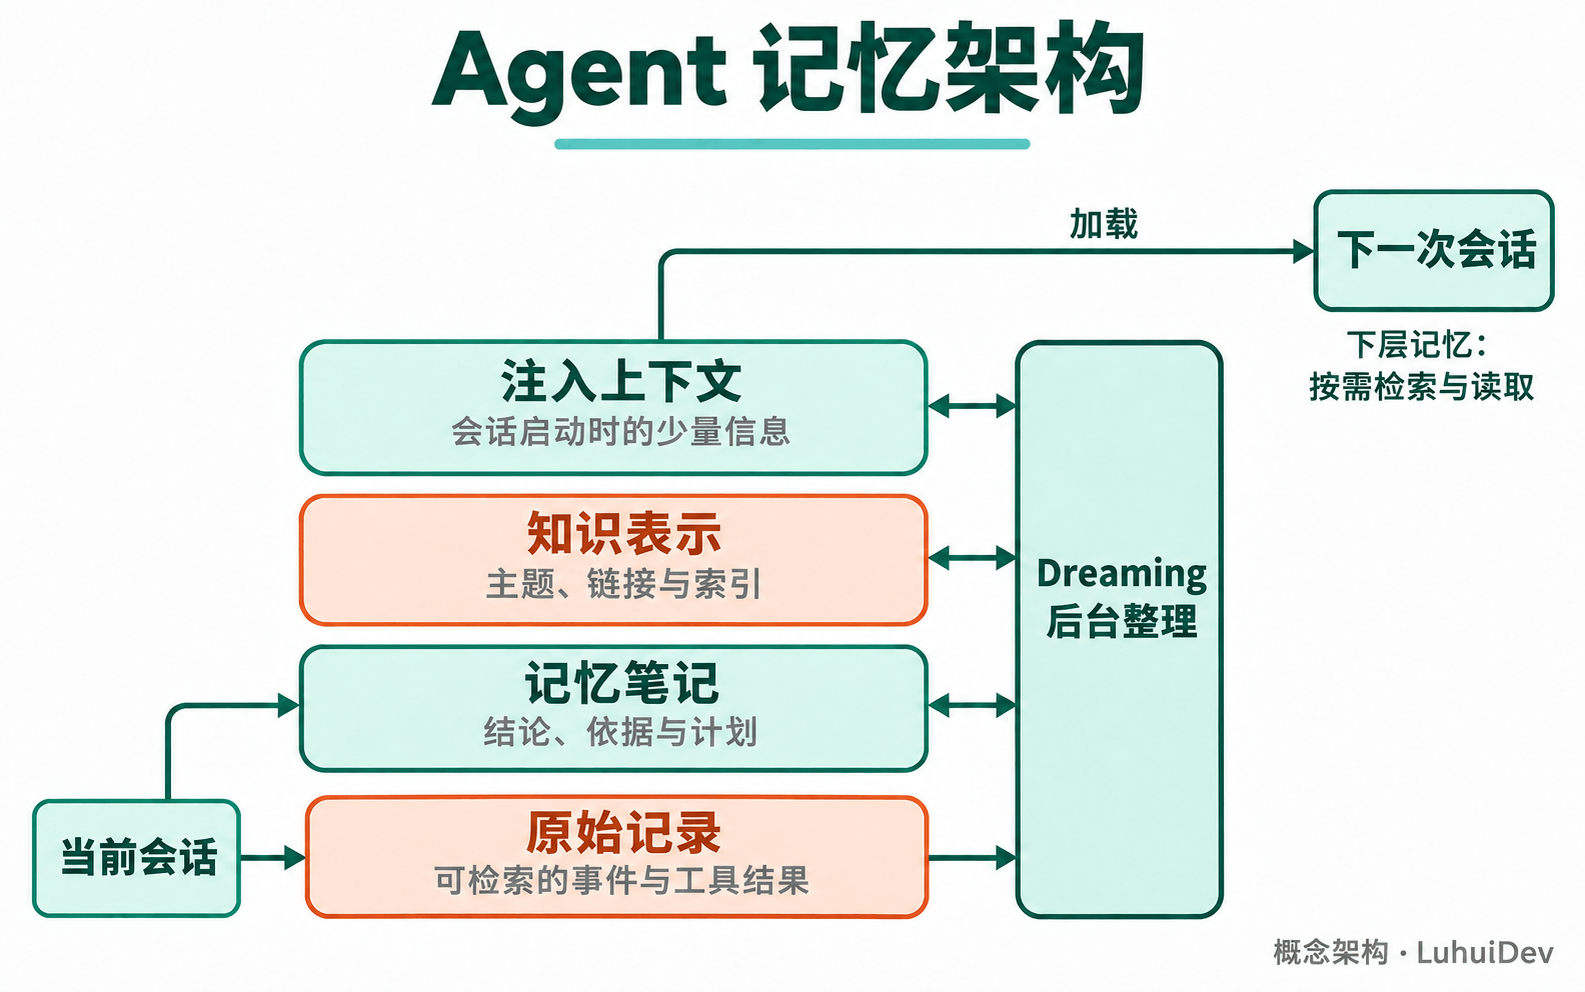
把每层存什么、常见的内容形式和存储方式放到一起,就更容易理解:
| 层次 | 存储的内容类型 | 常见组织形式 | 可选存储或承载方式 | 读取方式 |
|---|---|---|---|---|
| 原始记录 | 会话消息、工具调用、执行结果等事件 | 按时间排列的日志、JSONL 事件流 | 日志文件、数据库事件表、对象存储 | 按事件、时间或关键词检索 |
| 记忆笔记 | 经验规则、偏好、计划、带依据的结论 | Markdown 笔记、结构化条目 | 文件目录、数据库记录 | 按任务范围检索,再读取详情 |
| 知识表示 | 主题知识、概念关系、目录索引 | Wiki 页面、链接网络、主题索引 | 带链接的文档集合,也可用图数据库 | 沿主题、链接或索引导航 |
| 注入上下文 | 高频约定、重要提醒、记忆入口 | 精简入口文件、筛选后的记忆片段 | 持久层保存入口,运行时加载进上下文窗口 | 会话开始时自动加载 |
对小项目来说,一个只追加日志目录、一组 Markdown 主题页和一份简短索引,就足以试验这个结构。
原始记录细拆:保存证据
用测试命令举例。假设日志记录了三个事件:
E17:执行 pnpm test,失败,提示测试数据库不可用
E18:启动项目提供的测试数据库
E19:再次执行 pnpm test,通过
日志的边界是它能证明当时观察到了什么,不保证 Agent 的解释正确,更不保证项目以后一直如此。也因此未来可以重新检查具体操作和反馈。
如果日志还包含 Agent 的一句“看来任何测试失败都该重启数据库”,我们不能因为它出现在记录里,就把它视为同等强度的证据。
我的建议是让事件至少带上时间、项目、版本或提交标识、事件类型和内容位置。用户要求、工具观察和模型推断应能区分。这样上层记忆才有机会回到具体证据,而不是在一堆自然语言里互相引用。
记忆笔记细拆:把一次经历变成有条件的知识
从上述事件可以得到一条更稳妥的笔记:
在项目 A 的当前测试配置下,集成测试依赖可用的测试数据库。会话 42 中,启动数据库后测试通过。
它比原始记录多了适用范围,也保留了观察依据。
自己实现,我尝试让条目至少能够回答五个问题:结论是什么、适用于哪里、依据在哪里、什么时候验证、什么变化会使它失效。
字段可以按项目需要调整,重点是要保住结论与依据之间的联系。元数据也不必全部展示给模型,系统可以先按项目、版本过滤,再把当前需要的内容送进上下文。
记忆条目的质量,取决于它能否让后来者作出有依据的行动。
知识表示细拆:减少反复探索
当项目积累几百条记忆,仅靠文件名就很难知道该读什么的时候,可以增加主题页。如测试环境页链接数据库配置、发布页链接版本流程、回滚条件和部署记录等。
搜索能解决“有没有相关内容”,主题页则进一步提供“这些内容如何关联”。
例如用户问“为什么本地通过,CI 却失败”,关键词未必恰好出现在某一条笔记里,环境之间的差异却可能已经被主题页组织出来。
拿排查 CI 故障来说,一份主题页能先把环境差异、数据库依赖和历史决策串起来;碰到具体版本和报错,再回到搜索里找配置与日志。这样既不用每次从零梳理,也不会把主题页当成全部事实。
只维护 Wiki 容易遗漏细节,只保留搜索则可能反复付出整理关系的成本。两者可以一起用,重点是让任务少绕路。
我的取舍是:跨文档关系经常重复使用时,值得提前组织;偶尔查一个字段,直接搜索可能更划算。组织知识也有建设和维护成本。
注入上下文细拆:让 Agent 知道自己可以去哪里找
每次会话一开始,Agent 还不知道自己不知道什么。一份简短入口可以告诉它:当前项目在哪里、重要约定有哪些、测试和发布流程去哪里读。
以 Claude Code 的自动记忆为例,它只把 MEMORY.md 开头的一部分带入新会话,详细主题文件按需读取。入口负责告诉 Agent 自己记得什么、去哪里找,不必承载所有知识。
对于自己的测试系统,我把入口写成导航了:
当前项目:A
测试环境与命令:见 testing.md
发布与回滚条件:见 release.md
长期写作偏好:见 writing-preferences.md
是否注入某条信息,可以同时考虑使用频率、遗漏代价和内容长度。低频但遗漏代价很高的规则,可能比经常出现的普通状态更值得占据入口。
Dreaming 细拆:维护各层之间的转换
前面四层让 Agent 有地方保存经历,也有路径找回知识。下一个问题是 同一个项目做得越久,过去的投入能不能让下一次任务更容易完成?
昨天踩过的坑,今天能提前避开;散落在几次会话里的线索,能够拼成一条完整的判断;已经变化的操作方式,也能及时从开工入口里撤下来。做到这些,记忆才开始产生积累的价值。
Dreaming 承担的就是这部分后台工作。 任务进行时,Agent 先把注意力放在眼前的问题上;任务之外,再回看经历、核对结论、调整知识结构,让后续会话更容易拿到有用的信息。这确实也像极了人类的睡眠阶段。
但只要开始设计,就会发现“整理”里面藏着不少判断。
一条经验连续出现三次,是规律,还是同一个错误被重复了三次?新记录与旧笔记冲突,是环境变了,还是适用的项目不同?一条结论值得留在详细笔记里,又是否值得每次会话都提前加载?
这些判断会牵动多个层次。修正一条测试规则,可能同时需要更新记忆笔记、测试主题页和开工索引。
因此,Dreaming 的价值在于让经验持续变得可用,实现上的难点则是让每一次整理都有依据、能验证,也能在出错时退回来。
这里先抓住它在整个架构中的位置:它维护各层内容及其关系,为未来任务准备更可靠的记忆。至于怎样选择输入、判断冲突、验证结论和安全写回,值得单独拆开讲,我会在后续的《Anthropic Dreaming》中继续展开。
写在最后
我倾向于把 Agent 的记忆当作软件资产来维护。它有来源、范围和有效期,积累得越久,越需要有人处理其中的技术债。
日志让经历可以回查,笔记让经验可以复用,知识组织让关系更容易被找到,简短入口让下一次会话知道从哪里开始。后台整理则负责持续修正这些内容。
记忆的价值,最终要在未来的任务里兑现。