一個 Agent 昨天花了半小時找到正確的測試命令,今天換個新會話,又開始嘗試昨天已經失敗過的方案。
給它更長的上下文,倒是能緩解這個問題。但項目會持續變化,會話會繼續增長,這個成本也實在吃不住。
到底 Agent 做過一件事以後,系統究竟留下了什麼,下一次又如何把它變成有效幫助?
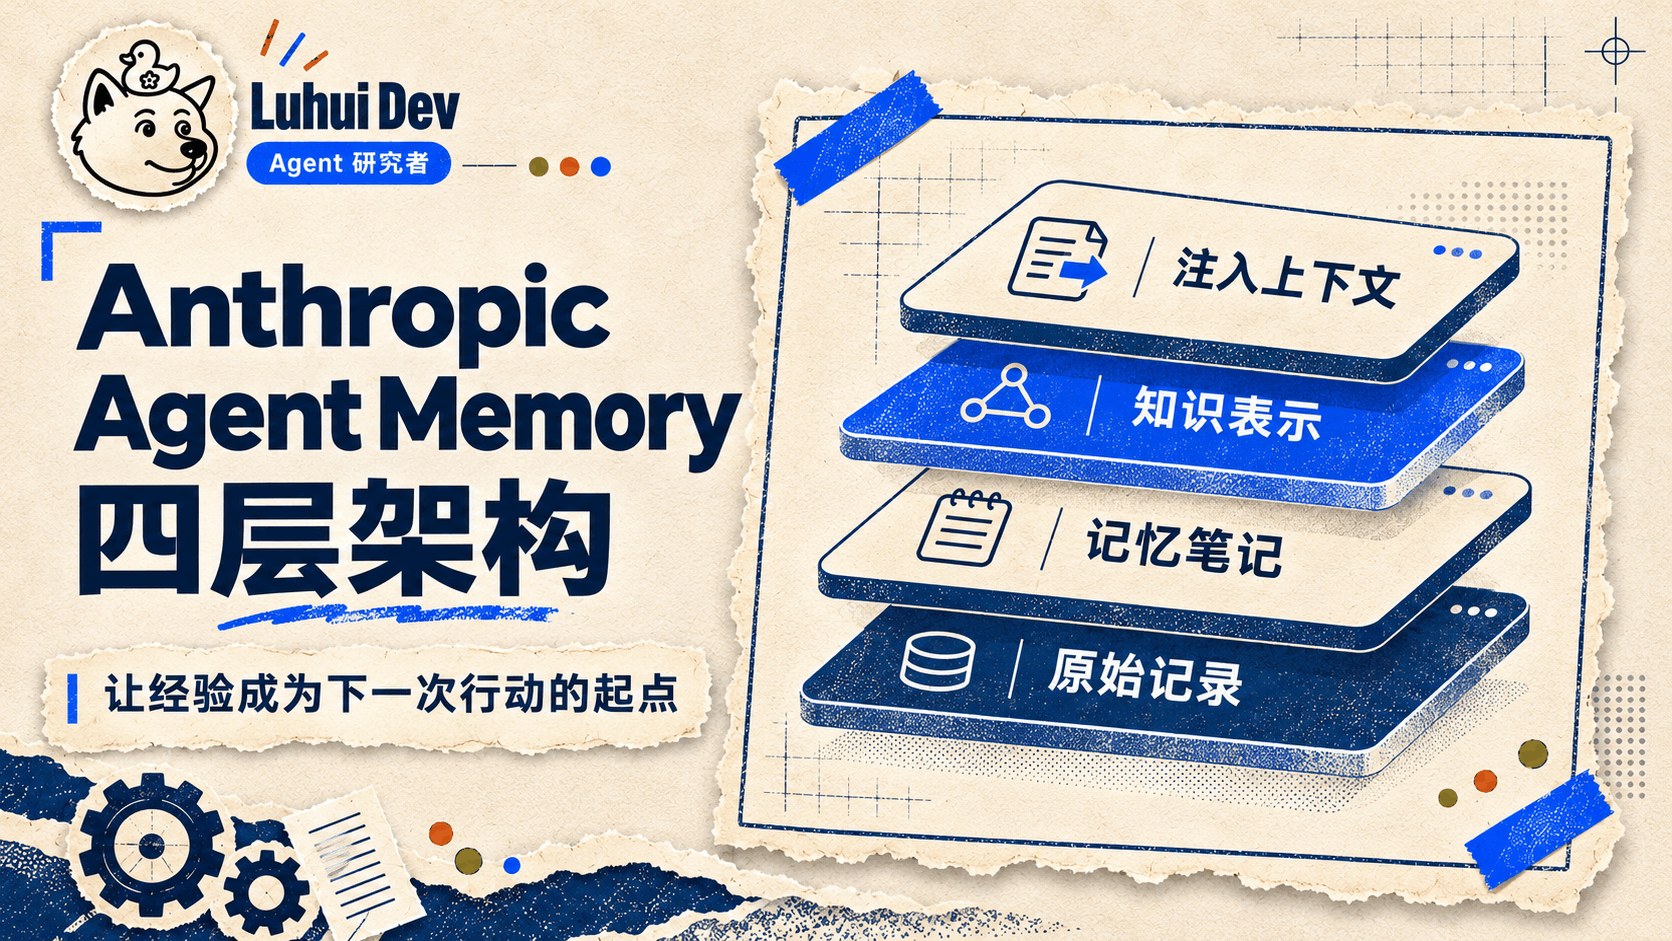
正好趁此機會重新學習理解 Anthropic 的 Agent Memory,發現架構中最關鍵的四件事:留下完整記錄,提煉可復用的經驗,把分散知識組織起來,給下一次會話一個簡短的開工入口。
我想沿著一個編碼 Agent 的工作過程,把這套結構拆開看看。
先把三種“記住了”分清楚
假設用戶告訴 Agent:“這個項目使用 pnpm。”
當前對話還能看到這句話,屬於當前上下文可用。
系統把它寫入持久檔案,下次會話還能讀到,屬於外部記憶。
模型經過訓練,參數發生變化,則是另一種學習機制。
這幾種機制都可能讓模型表現出“知道了”,卻需要不同的工程手段。
對應用開發者來說,外部記憶意味著我們可以檢查內容、找到來源、更新結論,也可以撤銷一次錯誤寫入。它有可操作的生命週期。
同樣需要區分的是對話壓縮。壓縮通常服務於當前任務繼續運行,長期記憶則要考慮跨任務復用。壓縮摘要可以成為記憶的材料,但把摘要長期保存,並不能自動解決過期、衝突和讀取時機。
所以我們需要先明確信息要活多久,再決定它應該住在哪裡。
四層架構:一圖看懂
Agent Memory 可以按信息的用途分成四層:原始記錄、記憶筆記、知識表示和注入上下文。它們分別保存完整經歷、從經歷中提煉的經驗、組織好的知識關係,以及每次會話開始前需要知道的少量信息。
這裡的“層”是信息的組織層次,不是四種資料庫,也不是每條信息都必須依次經過的流水線。
同一份檔案存儲就能承載多層內容;反過來,一層也可以由多種存儲共同支撐。
尤其是最上面的注入上下文,它通常由持久保存的入口檔案或記憶條目生成,在會話開始時加載進模型的上下文窗口。
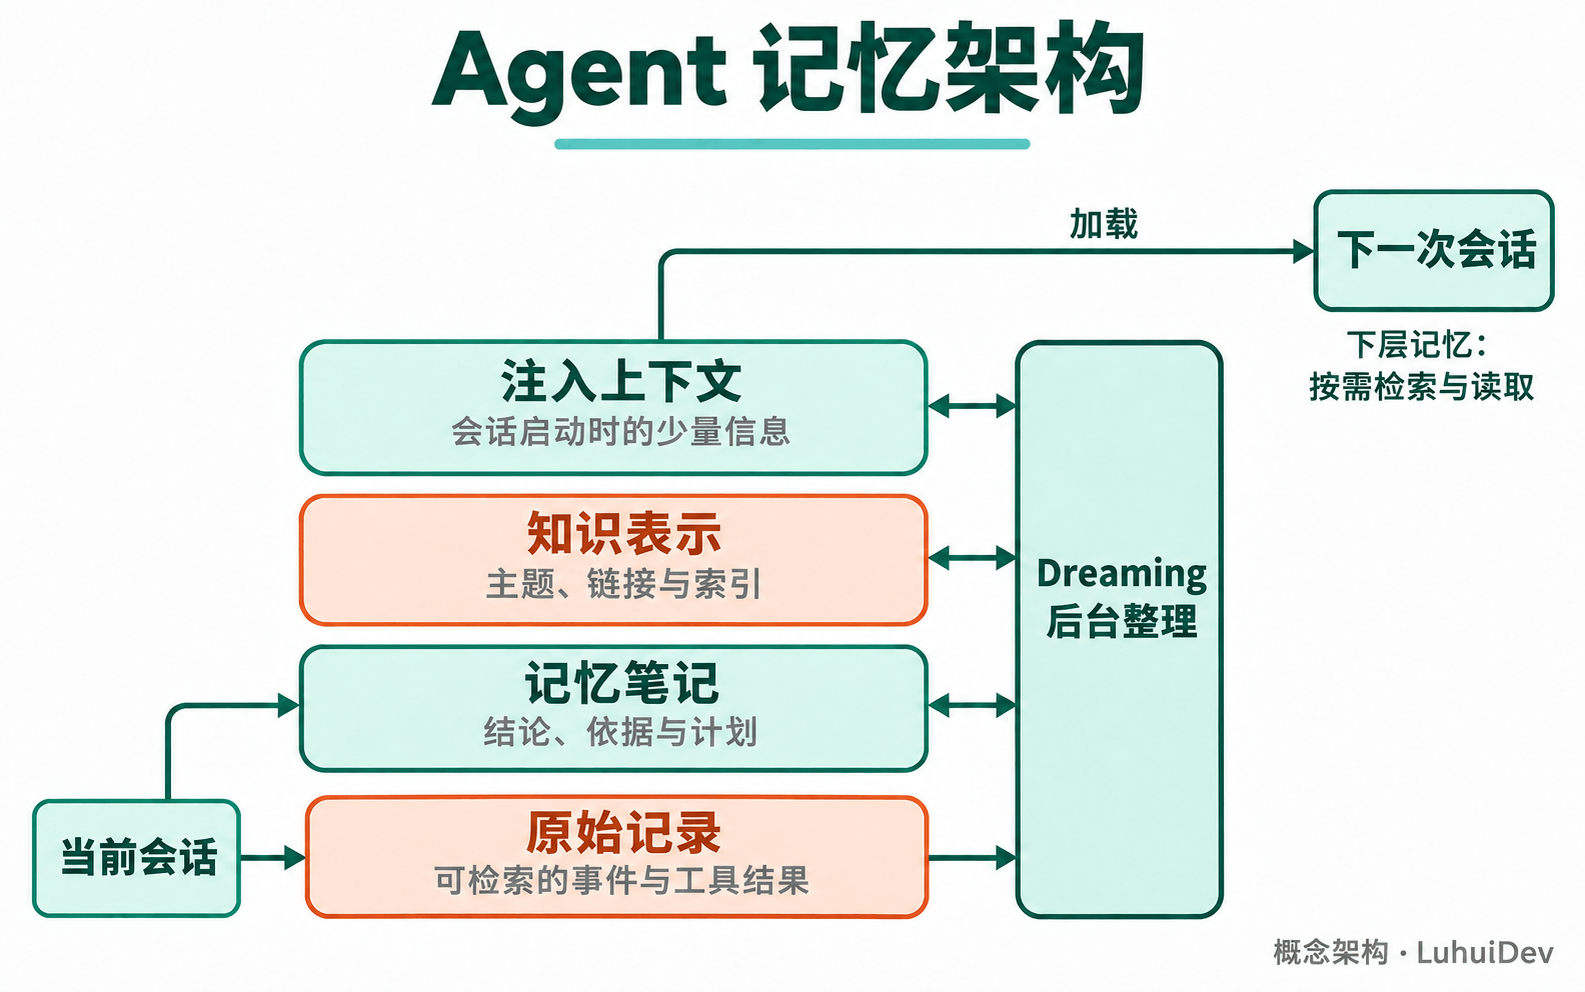
把每層存什麼、常見的內容形式和存儲方式放到一起,就更容易理解:
| 層次 | 存儲的內容類型 | 常見組織形式 | 可選存儲或承載方式 | 讀取方式 |
|---|---|---|---|---|
| 原始記錄 | 會話消息、工具調用、執行結果等事件 | 按時間排列的日誌、JSONL 事件流 | 日誌檔案、資料庫事件表、對象存儲 | 按事件、時間或關鍵詞檢索 |
| 記憶筆記 | 經驗規則、偏好、計劃、帶依據的結論 | Markdown 筆記、結構化條目 | 檔案目錄、資料庫記錄 | 按任務範圍檢索,再讀取詳情 |
| 知識表示 | 主題知識、概念關係、目錄索引 | Wiki 頁面、鏈接網絡、主題索引 | 帶鏈接的文檔集合,也可用圖資料庫 | 沿主題、鏈接或索引導航 |
| 注入上下文 | 高頻約定、重要提醒、記憶入口 | 精簡入口檔案、篩選後的記憶片段 | 持久層保存入口,運行時加載進上下文窗口 | 會話開始時自動加載 |
對小項目來說,一個只追加日誌目錄、一組 Markdown 主題頁和一份簡短索引,就足以試驗這個結構。
原始記錄細拆:保存證據
用測試命令舉例。假設日誌記錄了三個事件:
E17:執行 pnpm test,失敗,提示測試資料庫不可用
E18:啓動項目提供的測試資料庫
E19:再次執行 pnpm test,通過
日誌的邊界是它能證明當時觀察到了什麼,不保證 Agent 的解釋正確,更不保證項目以後一直如此。也因此未來可以重新檢查具體操作和反饋。
如果日誌還包含 Agent 的一句“看來任何測試失敗都該重啓資料庫”,我們不能因為它出現在記錄里,就把它視為同等強度的證據。
我的建議是讓事件至少帶上時間、項目、版本或提交標識、事件類型和內容位置。用戶要求、工具觀察和模型推斷應能區分。這樣上層記憶才有機會回到具體證據,而不是在一堆自然語言里互相引用。
記憶筆記細拆:把一次經歷變成有條件的知識
從上述事件可以得到一條更穩妥的筆記:
在項目 A 的當前測試配置下,集成測試依賴可用的測試資料庫。會話 42 中,啓動資料庫後測試通過。
它比原始記錄多了適用範圍,也保留了觀察依據。
自己實現,我嘗試讓條目至少能夠回答五個問題:結論是什麼、適用於哪裡、依據在哪裡、什麼時候驗證、什麼變化會使它失效。
字段可以按項目需要調整,重點是要保住結論與依據之間的聯繫。元數據也不必全部展示給模型,系統可以先按項目、版本過濾,再把當前需要的內容送進上下文。
記憶條目的質量,取決於它能否讓後來者作出有依據的行動。
知識表示細拆:減少反復探索
當項目積累幾百條記憶,僅靠檔案名就很難知道該讀什麼的時候,可以增加主題頁。如測試環境頁鏈接資料庫配置、發佈頁鏈接版本流程、回滾條件和部署記錄等。
搜索能解決“有沒有相關內容”,主題頁則進一步提供“這些內容如何關聯”。
例如用戶問“為什麼本地通過,CI 卻失敗”,關鍵詞未必恰好出現在某一條筆記里,環境之間的差異卻可能已經被主題頁組織出來。
拿排查 CI 故障來說,一份主題頁能先把環境差異、資料庫依賴和歷史決策串起來;碰到具體版本和報錯,再回到搜索里找配置與日誌。這樣既不用每次從零梳理,也不會把主題頁當成全部事實。
只維護 Wiki 容易遺漏細節,只保留搜索則可能反復付出整理關係的成本。兩者可以一起用,重點是讓任務少繞路。
我的取捨是:跨文檔關係經常重復使用時,值得提前組織;偶爾查一個字段,直接搜索可能更划算。組織知識也有建設和維護成本。
注入上下文細拆:讓 Agent 知道自己可以去哪裡找
每次會話一開始,Agent 還不知道自己不知道什麼。一份簡短入口可以告訴它:當前項目在哪裡、重要約定有哪些、測試和發佈流程去哪裡讀。
以 Claude Code 的自動記憶為例,它只把 MEMORY.md 開頭的一部分帶入新會話,詳細主題檔案按需讀取。入口負責告訴 Agent 自己記得什麼、去哪裡找,不必承載所有知識。
對於自己的測試系統,我把入口寫成導航了:
當前項目:A
測試環境與命令:見 testing.md
發佈與回滾條件:見 release.md
長期寫作偏好:見 writing-preferences.md
是否注入某條信息,可以同時考慮使用頻率、遺漏代價和內容長度。低頻但遺漏代價很高的規則,可能比經常出現的普通狀態更值得佔據入口。
Dreaming 細拆:維護各層之間的轉換
前面四層讓 Agent 有地方保存經歷,也有路徑找回知識。下一個問題是 同一個項目做得越久,過去的投入能不能讓下一次任務更容易完成?
昨天踩過的坑,今天能提前避開;散落在幾次會話里的線索,能夠拼成一條完整的判斷;已經變化的操作方式,也能及時從開工入口裡撤下來。做到這些,記憶才開始產生積累的價值。
Dreaming 承擔的就是這部分後台工作。 任務進行時,Agent 先把注意力放在眼前的問題上;任務之外,再回看經歷、核對結論、調整知識結構,讓後續會話更容易拿到有用的信息。這確實也像極了人類的睡眠階段。
但只要開始設計,就會發現“整理”裡面藏著不少判斷。
一條經驗連續出現三次,是規律,還是同一個錯誤被重復了三次?新記錄與舊筆記衝突,是環境變了,還是適用的項目不同?一條結論值得留在詳細筆記里,又是否值得每次會話都提前加載?
這些判斷會牽動多個層次。修正一條測試規則,可能同時需要更新記憶筆記、測試主題頁和開工索引。
因此,Dreaming 的價值在於讓經驗持續變得可用,實現上的難點則是讓每一次整理都有依據、能驗證,也能在出錯時退回來。
這裡先抓住它在整個架構中的位置:它維護各層內容及其關係,為未來任務準備更可靠的記憶。至於怎樣選擇輸入、判斷衝突、驗證結論和安全寫回,值得單獨拆開講,我會在後續的《Anthropic Dreaming》中繼續展開。
寫在最後
我傾向於把 Agent 的記憶當作軟體資產來維護。它有來源、範圍和有效期,積累得越久,越需要有人處理其中的技術債。
日誌讓經歷可以回查,筆記讓經驗可以復用,知識組織讓關係更容易被找到,簡短入口讓下一次會話知道從哪裡開始。後台整理則負責持續修正這些內容。
記憶的價值,最終要在未來的任務里兌現。