Introduccion
Al construir un coding agent, la capacidad del modelo base es solo una parte de la ecuacion. En escenarios reales de produccion, importa igual de mucho la capa de harness que envuelve al modelo: prompt, herramientas, middleware, memoria, entorno de ejecucion, trazas y pipeline de evaluacion.
Ese es precisamente el problema que aborda el paper de AHE: como hacer que el harness de un coding agent sea observable, modificable, evaluable, reversible e incluso autoiterable de forma continua, igual que en ingenieria de software.
El titulo completo del paper es "Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses", escrito por investigadores de Fudan University, Peking University y Shanghai Qiji Zhifeng Co., Ltd. Los equipos academicos aportan el diseno metodologico, mientras que el equipo industrial aporta experiencia en Agent/LLM Infra y sistemas Nex AGI.
Aun mejor: AHE tiene repositorio open source: china-qijizhifeng/agentic-harness-engineering.
Eso lo convierte en algo mas que un concepto de paper. Puedes inspeccionar directamente el seed coding agent, el evolve agent, las configuraciones de experimento, las trazas, los manifests y las estructuras de rollback. Para cualquiera que este construyendo coding agents, infraestructura de agents o productos agenticos mas amplios, este repositorio merece ser diseccionado.
Este articulo explora tres preguntas: por que AHE funciona, como evoluciona harnesses y como empezar un experimento pequeno con el repositorio.
Parte 1: Una introduccion rapida a Harness Engineering
Un harness puede entenderse como la carcasa de ingenieria externa que hace que un modelo trabaje de verdad. En un coding agent, normalmente incluye:
-
System prompt: define el modo basico de trabajo del agent
-
Tools: lectura y escritura de archivos, shell, busqueda, ejecucion de tests, modificacion de codigo, etc.
-
Tool descriptions: lo que el modelo ve sobre el uso de herramientas y sus schemas de parametros
-
Middleware: interceptacion, validacion, correccion y logging antes o despues de llamadas a herramientas
-
Memory: memoria de corto plazo, largo plazo y acumulacion de experiencia
-
Context management: compresion, poda y recuperacion de contexto
-
Execution environment: sandbox, permisos y aislamiento de runtime
-
Evaluation/observability: pruebas, trazas, logs, rewards, reportes de fallo y seguimiento de regresiones
Esta estructura determina como el modelo se aproxima a las tareas, invoca herramientas, maneja fallos y decide si termino.
Por ejemplo, cuando un comando de shell queda colgado en produccion, la solucion no es seguir agregando "no uses comandos interactivos" al prompt. Un enfoque mas robusto es agregar timeout a la shell tool, usar middleware para detectar comandos de alto riesgo, truncar salidas largas en la capa de respuesta y exigir comprobaciones de estado antes de completar la tarea.
Esa es la esencia de Harness Engineering: poner las capacidades del agent dentro de un sistema de runtime mantenible.
No profundizare mas en el concepto de Harness aqui. Si quieres seguir aprendiendo, busca palabras clave como Harness Engineering, Agent Harness, Agent Runtime, Tool-use Agent, Agent Observability, Agent Evaluation y Coding Agent Infrastructure.
Pasemos al foco principal de este articulo.
Parte 2: El posicionamiento central de AHE: harnesses de coding agents que se autoiteran
AHE significa Agentic Harness Engineering.
La frase clave del subtitulo del paper es: Observability-Driven Automatic Evolution of Coding-Agent Harnesses.
Se puede descomponer en tres capas:
Primero, AHE apunta a harnesses de coding agents. No entrena modelos nuevos ni modifica parametros del base model.
Segundo, realiza automatic evolution. El objetivo no es un ajuste manual y puntual de prompt, sino una evolucion continua del harness a traves de multiples ejecuciones.
Tercero, depende de observability. Los cambios vienen de trazas, logs, rewards, analisis de fallos y change manifests, no de una vaga "autorreflexion" escrita en un prompt.
Por tanto, la definicion precisa de AHE es:
Un framework de evolucion automatica para harnesses de coding agents. A traves de evidencia observable del runtime, mejora continuamente el prompt, las tools, el middleware, la memory, las skills y los sub-agents que rodean al agent.
Esta es la diferencia clave frente a la optimizacion ordinaria de prompts. AHE tambien modifica prompts, pero su espacio de accion es mucho mas grande: incluye tools, middleware y memory como estructuras evolucionables.
Parte 3: Los resultados experimentales de AHE
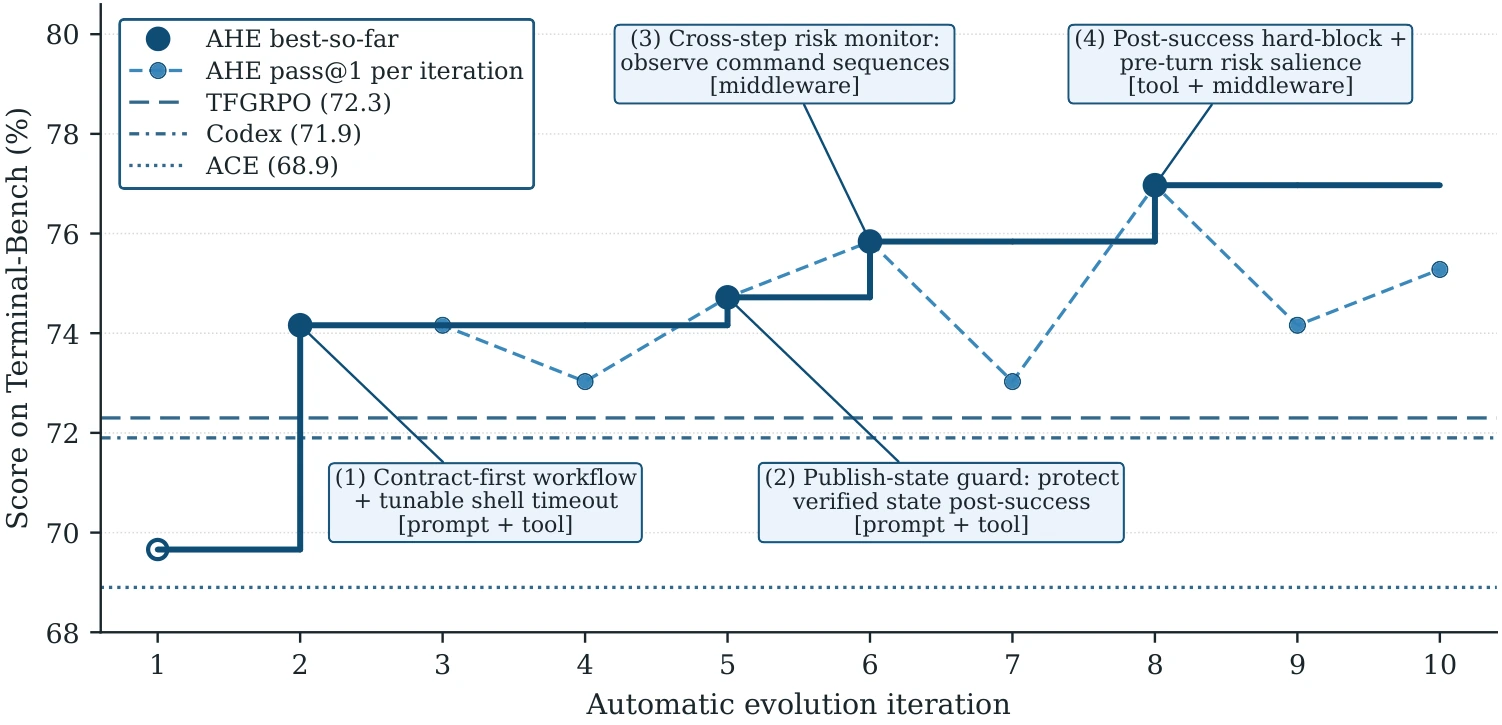
Los experimentos principales de AHE se ejecutaron sobre Terminal-Bench 2. El paper reporta que, tras 10 iteraciones, AHE mejoro el pass @1 del seed harness de 69.7% a 77.0%. Esto muestra que, en el benchmark objetivo, AHE encontro modificaciones efectivas del harness.
El estudio de ablation es aun mas revelador. El paper reemplaza individualmente distintos componentes de full AHE por el seed harness, con resultados aproximadamente asi:
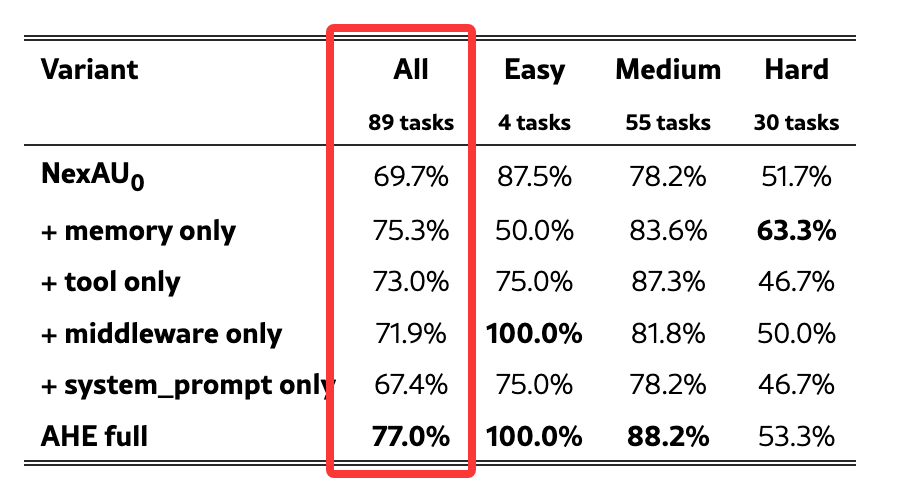
Este resultado contiene mucha informacion.
Si las ganancias vinieran sobre todo de mejores system prompts, la variante prompt-only deberia mejorar. Pero en el experimento, prompt-only baja, mientras que memory, tools y middleware muestran mejoras mas significativas.
Eso significa que los beneficios clave de AHE vienen de modificaciones estructurales del harness. Tambien sugiere que, en tareas complejas, muchos fallos de agents requieren mecanismos mas duros y mas orientados a ingenieria: comportamiento de herramientas, interceptacion en runtime, registro de estado, experiencia de largo plazo y pruebas de regresion.
El paper tambien realizo experimentos de transferencia. Cuando el harness evolucionado se traslado a SWE-bench-verified, las ganancias en tasa de exito fueron pequenas, pero el uso de tokens bajo de forma mas visible. Esto sugiere que las estructuras evolucionadas por AHE pueden ser mejores reduciendo exploracion inefectiva y desperdicio de contexto.
La transferencia entre modelos tambien es interesante. Cuando los harnesses generados por AHE se aplicaron a multiples base models, el paper reporta ganancias positivas en todos los casos. Eso indica que los componentes aprendidos contienen algunas estructuras de ingenieria transferibles.
Mi evaluacion: la prediccion de AHE sobre "que cambios arreglaran problemas" es claramente mejor que el azar, pero su prediccion sobre "que cambios causaran regresiones" todavia es relativamente debil. Aun asi, demuestra que los harnesses pueden evolucionar de manera continua, basada en archivos, basada en evidencia y controlada por versiones.
Parte 4: El flujo clave de AHE: evaluar, diagnosticar, modificar, verificar y hacer rollback
El bucle principal de AHE:
graph TD
    A[Harness actual] --> B[Ejecutar Code Agent en el benchmark]
    B --> C[Recolectar trace, log, reward]
    C --> D[Analizar patrones de fallo]
    D --> E[Evolve Agent modifica archivos del Harness]
    E --> F[Escribir change_manifest]
    F --> G[Reevaluar en la siguiente ronda]
    G --> H[Verificar si los cambios funcionan, rollback si hace falta]
    H -.-> A
Este bucle cerrado tiene tres actores principales.
El primero es el Code Agent.
Es el agent que realmente completa las coding tasks y el objeto que se esta optimizando. En el repositorio de AHE, el seed agent es bastante simple: basicamente un coding agent basado solo en bash.
El segundo es el Agent Debugger.
Lee las trazas de ejecucion del Code Agent y comprime trazas masivas en reportes de fallo legibles. Despues de una ejecucion de benchmark, las trazas crudas pueden ser extremadamente largas, por lo que leerlas directamente con un modelo seria demasiado costoso. Agent Debugger convierte esas trazas en overviews y analisis por tarea, dando evidencia para modificaciones posteriores.
El tercero es el Evolve Agent.
Lee los resultados de la ronda anterior, el analisis de fallos y el historial de modificaciones, y despues modifica archivos del harness dentro del workspace. Sus objetivos de modificacion incluyen prompts, tools, middleware, memory, skills, configuraciones de sub-agents, etc.
AHE agrega restricciones fuertes de ingenieria a este proceso:
Cada modificacion debe aterrizar en archivos. Cada modificacion requiere un manifest. La siguiente ronda debe verificar las predicciones del manifest. Los malos resultados deben poder revertirse. Todo el proceso debe dejar una cadena de evidencia auditable.
El self-reflection agent debe responder preguntas mas especificas: que archivo cambio, por que, que tareas espera arreglar, que tareas podria danar y si los resultados de la siguiente ronda validan ese juicio.
Parte 5: En que componentes evolucionables divide AHE el harness
El primer paso de AHE es dividir el harness en componentes explicitos.
El paper enfatiza varios tipos de objetos evolucionables:
System Prompt: define el comportamiento basico del Code Agent, como ejecutar shell de forma no interactiva, comprobar estado antes de terminar y no salir prematuramente.
Tool Descriptions: lo que el modelo ve sobre las herramientas. La herramienta en si podria no cambiar, pero si cambia su descripcion, tambien cambia la forma en que el modelo la invoca.
Tool Implementations: la implementacion real de la herramienta. Por ejemplo, como la shell tool ejecuta comandos, maneja timeouts, trunca salida y devuelve mensajes de error.
Middleware: capa de interceptacion en runtime. Puede comprobar antes o despues de tool calls, por ejemplo detectando comandos peligrosos, recordando tareas no verificadas, bloqueando finales prematuros o registrando estados de riesgo.
Skills: experiencia reutilizable. Piensa en ellas como manuales operativos para ciertos patrones de tarea.
Sub-agents: configuraciones de sub-agents. Las tareas complejas pueden dividirse entre distintos roles.
Long-term Memory: memoria de largo plazo para acumular experiencia entre tareas y rondas.
Esta descomposicion da al Evolve Agent un espacio de accion mas rico. Puede elegir el punto correcto de intervencion segun la evidencia de fallo.
Ejemplo: el Code Agent se queda colgado una y otra vez en shell. El enfoque menos eficiente es agregar mas recordatorios al prompt. El camino de AHE es mas ingenieril: agregar timeout a la shell tool; hacer que el middleware revise comandos obviamente interactivos; devolver mensajes que indiquen explicitamente la razon del fallo; y complementar el system prompt con restricciones de comportamiento.
Estas modificaciones estructurales son mas estables y mas faciles de reutilizar y revertir.
La clave es entender el posicionamiento: los prompts son sugerencias de comportamiento; tools, middleware y memory son mecanismos de ejecucion.
El valor de AHE esta en llevar esos mecanismos de ejecucion al alcance de la evolucion.
Parte 6: Tres capas de observabilidad: como AHE evita la busqueda ciega
Dejar que un agent modifique archivos al azar y vuelva a ejecutar benchmarks tiene valor limitado. El diseno central de AHE son tres capas de observabilidad.
1. Component Observability
Component observability significa que el sistema sabe que partes componen el harness, donde esta cada parte, como se modifica y como se registra.
En el repositorio de AHE, prompts, tool descriptions, tool implementations, middleware, memory, etc., aparecen como archivos. Las nuevas tools necesitan descripciones YAML e implementaciones Python, ademas de registro en config; el nuevo middleware necesita integracion explicita; y las nuevas skills o sub-agents tambien deben exponerse mediante configuracion.
2. Experience Observability
Experience observability significa que, despues de que un agent se ejecuta, el sistema registra como tuvo exito o como fallo.
AHE recolecta la trace, runtime log, reward, etc. de cada tarea. Luego Agent Debugger comprime esas trazas crudas en reportes de analisis.
Cuando un coding agent falla, saber simplemente "fallo" no sirve mucho. Lo que realmente necesitas localizar es el nivel del fallo: fallo de ejecucion de comando, fallo de instalacion de dependencias, tests no ejecutados, error de ruta de archivo, salida demasiado larga que contamina el contexto, agent que decide prematuramente que termino, o perdida de estado previo en tareas largas.
A traves de traces y analysis, AHE convierte los fallos en evidencia legible, resumible y accionable.
3. Decision Observability
Despues de cada modificacion, el Evolve Agent debe escribir un change_manifest.json. Este manifest registra que archivos cambiaron, que patron de fallo atacan, por que se eligio ese componente, que tareas se espera arreglar, cuales podrian sufrir regresion y la fuerza de la restriccion introducida.
Despues de la siguiente ronda de evaluacion, el sistema revisa este manifest para ver si las predicciones se cumplieron.
Este paso convierte cada modificacion en una hipotesis verificable. Incluso sin usar el pipeline completo de evolucion automatica de AHE, introducir el habito de change manifest en tu propio equipo de agents mejora inmediatamente la transparencia de ingenieria.
Muchos proyectos de agents se vuelven dificiles de mantener justamente por esto: muchos cambios de prompt, muchos ajustes de tools, pero nadie sabe que resolvio cada cambio y nadie sabe si introdujo nuevos problemas. El mecanismo de manifest de AHE al menos hace que el proceso sea auditable.
Parte 7: La organizacion de ingenieria de AHE vista desde el repositorio
El punto de entrada principal del repositorio de AHE es evolve.py. Orquesta todo el workflow de evolucion, incluyendo inicializacion del workspace, ejecucion de evaluaciones, manejo de directorios de iteracion, atribucion, recuperacion y rollback.
El seed agent que se evoluciona esta en agents/code_agent_simple/, e incluye:
code_agent.yaml describe como este agent carga prompts, que tools usa y que tracer emplea.
systemprompt.md es el system prompt inicial.
LongTermMEMORY.md y ShortTermMEMORY.md corresponden a las interfaces de memoria de largo y corto plazo. tool_descriptions/ contiene descripciones de herramientas, y tools/ contiene implementaciones.
El Evolve Agent esta en agents/evolve_agent/. Archivos clave que vale la pena examinar:
evolve_agent.yaml define que tools, middleware y skills puede usar el propio Evolve Agent.
evolve_prompt.md es un contrato de evolucion: especifica que el Evolve Agent solo puede modificar el workspace, debe hacer cambios basados en evidencia, debe escribir summaries y manifests, y debe seguir reglas de registro.
Los archivos de configuracion estan en configs/ y configs/experiments/. configs/base.yaml es la configuracion base, y configs/experiments/exp-simple-code-gpt54.yaml es un overlay cercano a los experimentos del paper.
Los scripts de lanzamiento estan en scripts/, como scripts/evolve.sh para iniciar experimentos largos y scripts/build_templates.py para construir task templates para E2B.
Si solo quieres entender el proyecto, no necesitas leer todos los archivos a la vez. Recomiendo este orden:
README
  ↓
agents/code_agent_simple/code_agent.yaml
  ↓
agents/code_agent_simple/systemprompt.md
  ↓
agents/evolve_agent/evolve_prompt.md
  ↓
configs/base.yaml
  ↓
configs/experiments/exp-simple-code-gpt54.yaml
  ↓
evolve.py
Esta secuencia ayuda a construir primero los conceptos y despues ver los detalles de ejecucion.
Parte 8: Como empezar con el repositorio: primero ejecuta un experimento pequeno
AHE no es un SDK liviano. No puedes esperar hacer pip install e incrustarlo inmediatamente en sistemas de produccion.
Se parece mas a un framework de experimentacion de investigacion. Ejecutar experimentos al nivel del paper requiere LLM API, sandbox E2B, SERPER API, datos de benchmark, scheduling concurrente y costes de tokens considerables.
Por eso, una forma mas realista de empezar es ejecutar primero un bucle cerrado minimo.
Define el objetivo asi: hacer que el pipeline central de AHE corra.
Es decir:
graph LR
    A[Ejecucion de tarea] --> B[Generacion de trace]
    B --> C[Generacion de analysis]
    C --> D[Escritura de change_manifest]
    D --> E[Reevaluacion en la siguiente ronda]
    E --> F[change_evaluation<br>juzga el efecto de la modificacion]
Cuando este pipeline funciona, entiendes el valor practico de AHE.
1. Clona el repositorio
Repositorio oficial:
git clone https://github.com/china-qijizhifeng/agentic-harness-engineering.git
cd agentic-harness-engineering
2. Instala dependencias
El proyecto usa uv para gestionar dependencias de Python.
uv sync
3. Configura variables de entorno
Copia la plantilla de variables de entorno:
cp .env.example .env
Como minimo, presta atencion a estas variables:
LLM_API_KEY
LLM_BASE_URL
E2B_API_KEY
SERPER_API_KEY
GITHUB_TOKEN
Agent Debugger tambien puede configurar endpoints de modelo por separado. Consulta .env.example para los detalles.
Una nota importante: la ejecucion de tareas de AHE depende de E2B sandbox. Mucha ejecucion de codigo ocurre en entornos remotos aislados. Esto ayuda con seguridad y reproducibilidad, pero tambien significa que necesitas una cuenta y creditos de E2B.
4. Prepara benchmark task templates
El workflow oficial requiere construir primero task templates. Comando de ejemplo:
uv run python scripts/build_templates.py --dataset-dir /path/to/dataset -j 16
Reemplaza /path/to/dataset por la ruta real de tus datos de tareas.
Si solo estas haciendo un experimento pequeno, no recomiendo preparar todo Terminal-Bench 2 al inicio. Selecciona unas pocas tareas y haz que el pipeline funcione primero; eso es mas importante.
5. Empieza con una configuracion pequena
Para la configuracion de experimento del paper, revisa:
configs/experiments/exp-simple-code-gpt54.yaml
Ejecutar la configuracion completa es costoso. Copia una configuracion pequena, por ejemplo:
cp configs/experiments/exp-simple-code-gpt54.yaml configs/experiments/exp-mini.yaml
Luego reduce los parametros:
max_iterations: 2
harbor:
  k: 2
  n_concurrent: 4
Si la config permite especificar subconjuntos de tareas, usa solo 3 a 5 tareas. El objetivo del experimento pequeno es validar el workflow, no perseguir puntuaciones.
6. Lanza el experimento de evolucion
Puedes usar el script:
./scripts/evolve.sh configs/experiments/exp-mini.yaml
O mirar dentro del script para ver como llama a evolve.py, y luego lanzarlo manualmente segun lo necesites.
Los experimentos completos pueden correr durante mucho tiempo. Incluso los pequenos requieren atencion a costes de API, limites de concurrencia de E2B y estabilidad de red.
7. Mira los artefactos del experimento, no solo las puntuaciones
Despues de ejecutar, no mires solo el pass rate.
Lo mas valioso es examinar estos artefactos:
runs/iteration_*/
analysis/overview.md
analysis/detail/*.md
change_manifest.json
change_evaluation.json
agent/nexau_in_memory_tracer.cleaned.json
verifier/reward.txt
Despues de correr, observa y responde estas preguntas:
-
Que patrones se atribuyeron a los fallos de esta ronda?
-
Que archivos cambio el Evolve Agent?
-
Por que eligio cambiar esos archivos?
-
Que tareas predice el manifest que se arreglaran?
-
La siguiente ronda verifico esa prediccion?
-
Hubo casos donde arreglar una tarea rompio otra?
Si puedes encontrar respuestas a todas estas preguntas en los artefactos, significa que el bucle cerrado central de AHE ya esta funcionando.
Parte 9: Lo que AHE todavia no ha resuelto
AHE es valioso, pero tambien conviene dejar claros sus limites.
Primero, sigue siendo un framework de investigacion. Las ejecuciones completas no son baratas: requieren benchmarks, sandboxes, LLM APIs y configuraciones de experimento bastante complejas.
Segundo, la evidencia de efectividad del paper necesita mas experimentos de replicacion. La mejora en Terminal-Bench 2 es clara, pero para conclusiones estadisticas fuertes hacen falta mas seeds, mas campaigns y mas intervalos de confianza.
Tercero, su prediccion del riesgo de regresion no es lo bastante fuerte. El sistema es mejor explicando que podria arreglar una modificacion que juzgando que podria danar. Ese es un problema dificil para los sistemas de evolucion automatica.
Parte 10: La inspiracion de AHE para equipos de producto agentico
La mayor inspiracion de AHE para equipos que construyen productos con agents es sacar el proceso de mejora de agents del "prompt tuning mistico" y devolverlo al mundo de la ingenieria.
Un producto real basado en agents tarde o temprano enfrentara estas preguntas:
-
Cuando un usuario reporta un error, como lo reproduces?
-
Como agregas las causas de fallo?
-
Una modificacion concreta de prompt realmente ayudo?
-
Un cambio en una tool introdujo regresiones en otros escenarios?
-
Hay pruebas de regresion antes del release?
-
Puedes hacer rollback si el rendimiento en produccion empeora?
-
Como destilas experiencia efectiva en memory o skills?
Ningun modelo individual puede resolver estos problemas por ti.
Pertenecen al ambito del harness engineering.
Si tambien estas construyendo tu propio agent, este repositorio merece una diseccion cuidadosa. Incluso sin ejecutarlo por completo, puedes aprender mucho sobre organizacion de harnesses, diseno de traces, atribucion de modificaciones y metodos de ingenieria para verificacion de regresiones.
Preguntas frecuentes
En que se diferencia AHE de la optimizacion de prompts?
La optimizacion de prompts modifica principalmente las instrucciones que ve el modelo. AHE tiene un espacio de accion mas amplio: trata system prompts, tool descriptions, tool implementations, middleware, memory, skills, sub-agents, evaluacion y rollback como componentes evolucionables del harness.
Por que un coding agent harness afecta el rendimiento del agent?
Un coding agent harness controla como el modelo lee un repositorio, invoca herramientas, ejecuta comandos de shell, gestiona contexto, registra trazas, ejecuta tests y decide si una tarea esta completa. Con el mismo base model, el diseno del harness puede cambiar la fiabilidad, el coste y la reproducibilidad.
Que deberian adoptar primero los equipos de AI engineering?
El primer paso practico no es automatizar toda la evolucion del harness. Empieza por la observabilidad: capturar traces, resumir causas de fallo, escribir change manifests, ejecutar regresiones y hacer que cada cambio de harness sea explicable, verificable y reversible.
Referencias
-
Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses arXiv: https://arxiv.org/abs/2604.25850
-
Repositorio oficial de AHE GitHub: https://github.com/china-qijizhifeng/agentic-harness-engineering
-
Harness engineering: leveraging Codex in an agent-first world OpenAI Engineering Blog: https://openai.com/index/harness-engineering/