前言
剛開始做 Multi-Agent 時,很容易被它的形式吸引。
一個 Agent 負責規劃,一個負責執行,一個負責審核。複雜一點,再加研究員、程式設計師、測試員和審核員。控制台裡不斷出現新的任務、訊息和工具呼叫,幾個 Agent 同時運行,看起來很專業。
但做得越深,我越發現另一面:Multi-Agent 下任務拆出去了,但責任沒有拆清楚;訊息傳過去了,資訊卻沒有真正被重視;審核流程走完了,結果依然不能用。
單 Agent 的問題比較直觀:沒有理解需求、工具呼叫失敗,或寫錯程式碼,通常能沿著一條執行軌跡找到原因。Multi-Agent 就沒那麼好處理,它把問題分散到任務拆解、脈絡傳遞、共享狀態、角色權限和結果驗收中。最後看到的一次普通失敗,真正的錯誤可能在十幾輪對話之前已經發生。
過去一段時間,無論是自己做 Plan-Exec、給執行 Agent 增加 Supervisor,還是觀察 Anthropic、Google、Cursor 對大規模 Agent 系統的實驗,我越來越傾向於一個判斷:
Multi-Agent 不是把一個聰明人變成一家公司,反而是把一個模型的問題擴展成了一套組織問題。
下面分享我的七個判斷。
一、能寫出五個角色,不等於任務真的能拆成五份
Multi-Agent 最容易做的事,是定義角色:產品經理理解需求,架構師設計方案,程式設計師編寫程式碼,測試員驗證功能,CEO 負責最終決策。
這樣的流程讀起來很合理,因為它照搬了人類公司的組織結構。真正執行起來,經常不是這麼回事。
我在設計 Plan-Exec 流程時,遇過這樣的情況:Planner 給出的任務清單文字上很完整,Executor 卻不知道每一步該交付什麼可驗證結果。一個任務寫著「分析圖片中的幾何關係」,另一個寫著「根據分析完成作圖」,但前者究竟該回傳自然語言、結構化關係,還是可直接執行的幾何 DSL,並沒有被確定。結果是第一個 Agent 寫了一篇分析,第二個 Agent 又從頭看圖,所謂分工只增加了一次資訊轉述。
伯克利團隊分析七種 Multi-Agent 系統和兩百多條執行軌跡,發現約 41.77% 的失敗屬於規格與系統設計問題:Agent 不遵守任務要求、角色失效、步驟重複、脈絡遺失,或無法判斷任務是否完成。[1]
問題不在於角色名稱寫得不夠詳細。人類組織中的角色背後,還有長期經驗、責任邊界、專業標準和預設共識。 把「你是一名資深測試工程師」寫進 system prompt,只是給模型增加一段語言背景,並沒有自動補上這些制度。
角色是一種敘事,介面才是一種工程。如果一個子任務沒有明確輸入、輸出、完成條件和失敗狀態,它就不該交給另一個 Agent。
二、看起來可以平行的任務,往往暗藏一條不能切斷的思考鏈
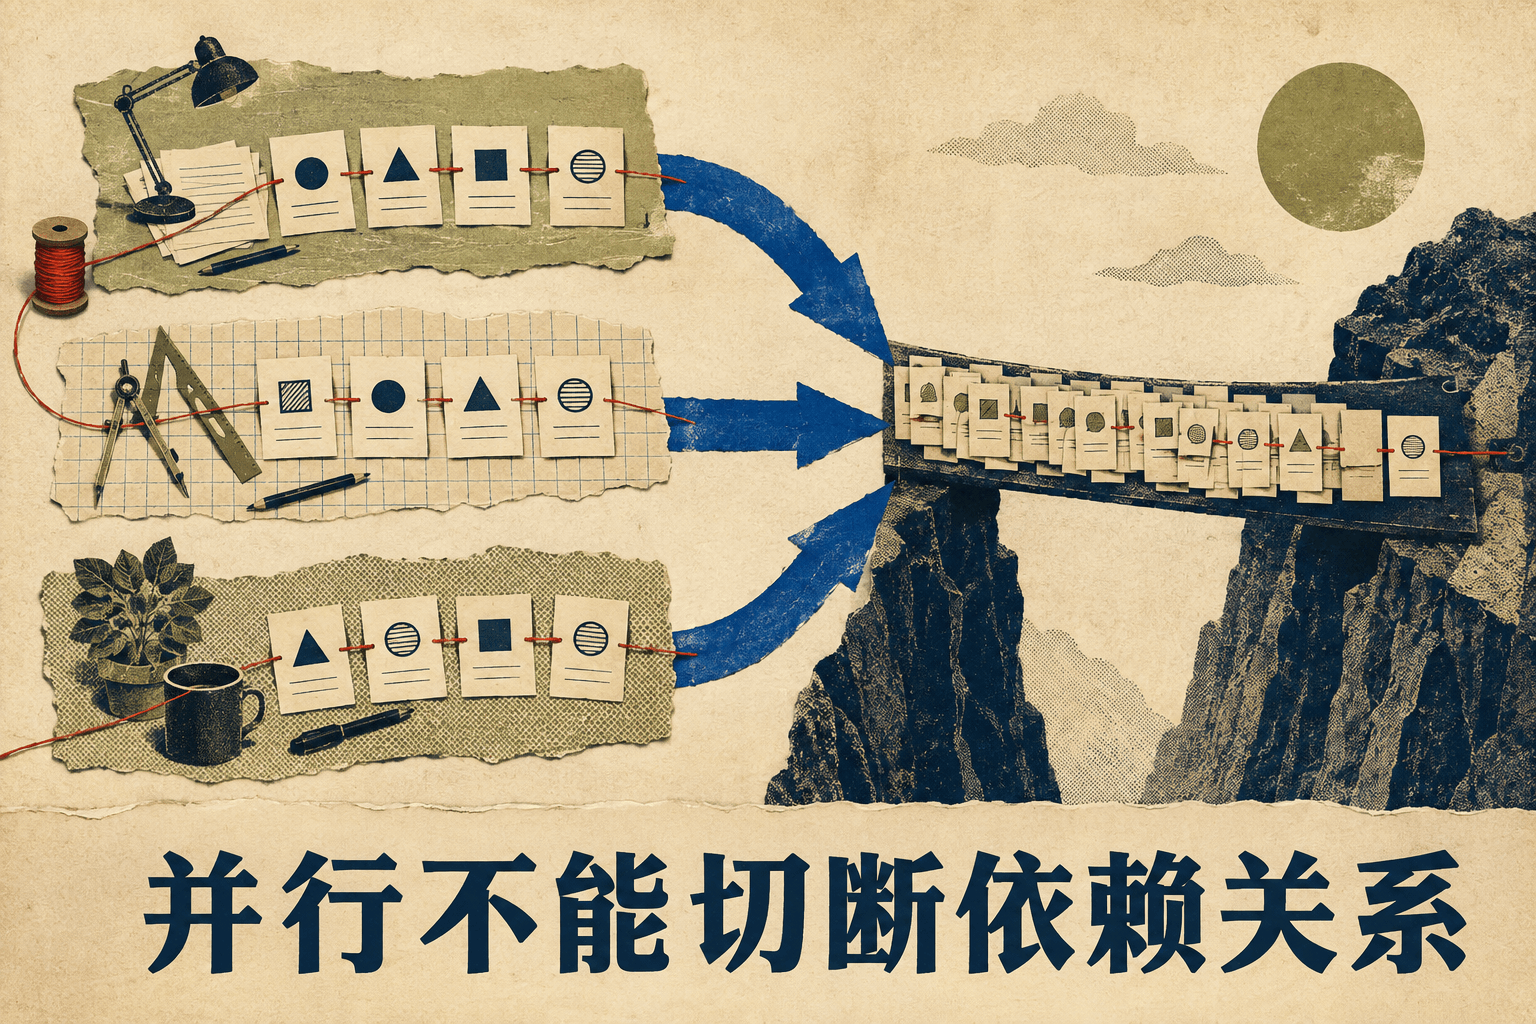
多 Agent 在資料搜尋中表現很好,這不奇怪。調查幾十家公司、搜尋多個程式碼倉庫的漏洞,或從大量網頁收集分散事實,都可以按對象或方向切分;某個分支沒有找到結果,也不會破壞其他分支。
但 Anthropic 的 Research 明確指出,涉及大量共享脈絡和相互依賴的任務,並不適合現在的 Multi-Agent。編碼任務尤其如此,因為真正能完全獨立平行的部分,經常比想像中少。[2]
平行能縮短工作量,卻不能縮短依賴關係。
Google Research 在 180 種 Agent 配置上的實驗給出相近結果:可平行分析的金融任務中,集中式 Multi-Agent 比單 Agent 提升 80.9%;到了強調連續規劃的 PlanCraft,所有多 Agent 架構都下降,幅度在 39% 到 70% 之間。[3]
每一次交接都要重新解釋當前狀態。前一個 Agent 的完整判斷被壓縮成一段輸出,後一個 Agent 再根據它還原現場。原本連續的推理被切成幾段,系統把更多 token 花在彼此解釋上,留給任務本身的計算反而更少。
三、Agent 數量一多,最先成長的是重複勞動
Multi-Agent 的運行日誌很容易讓人產生錯覺:幾個 Agent 同時搜尋,Supervisor 不斷下發任務,執行器輪流呼叫工具,介面上持續出現「正在分析」「正在驗證」和「正在改進」。只看過程,非常努力。
但細看,常能看到幾份相近的搜尋結果、幾段意思相同的分析,以及被不同 Agent 重複讀取的專案背景。系統消耗更多 token,卻沒有得到相同比例的新資訊。
MAST 統計中,步驟重複是出現最多的單項失敗,占 17.14%。論文還記錄一個很樸素的案例:使用者要求取得播放清單的前十首歌,Spotify Agent 本可一次回傳全部結果,編排器卻與它進行十輪交流,每次取回一首。[1]
這類問題通常不是模型缺少能力,而是系統不知道應按什麼粒度分配任務。 有時 Supervisor 發現輸出不對,只給一段泛泛的自然語言回饋;Executor 沒定位到具體錯誤,只好重跑整個任務。新舊結果稍有不同,Supervisor 又重查一次。它們沒有圍繞確定缺陷修復,只是在同一區域反覆取樣。
有些 Multi-Agent 不是在協作,只是在互相製造閱讀材料。
四、把任務池交給 Agent 自治,最後往往沒人對難題負責
一種很有吸引力的設計,是讓多個平等 Agent 查看共享任務池,自主決定接下來做什麼。它符合人們對「湧現式協作」的想像:設計者不再規定固定流程,Agent 根據現場情況認領任務、更新狀態,並等待其他 Agent 的成果。
Cursor 在長時間編程實驗中試過這種方案。Agent 透過共享檔案協調,並用鎖防止重複認領。Agent 會長時間占用鎖、忘記釋放鎖、持鎖退出,也會不拿鎖直接修改檔案。二十個 Agent 同時運行時,最終只能產生相當於一到三個 Agent 的有效吞吐,大部分時間花在等待上。
去掉悲觀鎖、改用樂觀並發後,檔案爭用減輕,責任問題又出現。Agent 開始選擇局部、安全、容易完成的修改,沒有誰願意接手複雜而高風險的核心工作。倉庫裡不斷出現小提交,專案最難的部分卻沒有進展。[4]
這和人類組織中的責任稀釋很像。差別在於,Agent 不會因專案延期感到壓力,也不會因長期只做邊角任務影響職業評價。最終交付不能依靠一群沒有最終責任人的 Worker 自然湧現出來。
五、資訊發到了群裡,不代表系統中的其他 Agent 知道了
在 Multi-Agent 系統裡,經常能看到一條關鍵資訊已經出現,卻沒有對後續行動產生影響。MAST 記錄過一個案例:Phone Agent 發現 API 對使用者名稱格式有特殊要求,卻沒把此限制明確傳給 Supervisor。Supervisor 也沒有追問,只是繼續用錯誤格式登入,直到整個任務失敗。[1]
實際執行中也很常見:Supervisor 看到幾何圖中的一個點位置錯誤,只回饋「圖形與題意不完全一致」,執行 Agent 便調整線條樣式;某個 Agent 發現需求有矛盾,卻把它當普通備註放在輸出末尾,後面的 Agent 仍沿原計畫繼續。
自然語言訊息對人類帶有語氣、優先級和行動暗示。Agent 接收到的只是一段脈絡。除非系統明確告訴它哪些內容是約束、哪些是決定、哪些會阻塞後續步驟,它未必知道一條事實的重要性。
六、同一個模型複製十份,只會得到十份相似的盲區
我們常假設:一個 Agent 可能犯錯,三個 Agent 投票應更可靠;執行 Agent 可能遺漏問題,再加一個 Reviewer 就能發現。這個邏輯成立的前提,是不同 Agent 的錯誤相對獨立。但使用相同模型、相似提示詞和同一批資料時,此前提經常不成立。
Anthropic 發現三十個 Agent 中有十八個建立完全相同的 Git 分支名;多個創作 Agent 在沒有題材提示時,替小說選擇同一標題;讓每個 Agent 自由創作一個「令人印象深刻的專案」,超過一半選了光線追蹤器或自舉編譯器。[5]
同質性在單個任務中表現為重複,在大規模系統中就可能表現為擁堵、踩踏或共同誤判。 Google 的研究也發現,沒有中心協調的獨立 Agent 會把錯誤最多放大 17.2 倍;加入編排器後,仍達到 4.4 倍。多個 Agent 形成一致意見時,不能把 Agent 數量直接當成證據數量;它們可能只是沿著相同的訓練偏差和提示詞錨點,抵達同一個錯誤答案。
七、Agent 辯論經常沒有糾正錯誤,只是替錯誤補齊理由
有些系統試圖用辯論解決同質性:讓一個 Agent 提出答案,另一個 Agent 反駁,再經過兩三輪討論投票。流程看起來像同行評審,實際卻可能變成第一個 Agent 給出措辭完整的錯誤解釋,其他 Agent 沿著它的前提繼續推理。後面的理由越來越豐富,最初的錯誤反而被包裝得更可信。
一項針對十個同質 Agent、三輪辯論的研究發現,Agent 採用多數意見的比例最高達 85.5%。一些原本答對的 Agent,在看到同伴意見後改成錯誤答案。與各自獨立自我修正相比,辯論消耗 2.1 到 3.4 倍 token,準確率卻相同或更低。[6]
模型特別擅長接續既有文本。第一個答案一旦進入公共脈絡,後面的 Agent 就不再面對一張白紙;它們可能是在審查答案,也可能只是在受答案影響。沒有獨立判斷的辯論,很容易變成一場高成本的互相附和。
參考資料
[1] Cemri, Mert et al. Why Do Multi-Agent LLM Systems Fail?. arXiv, 2025.
[2] Anthropic. How we built our multi-agent research system.
[3] Google Research. Towards a science of scaling agent systems: When and why agent systems work.
[4] Cursor. Scaling long-running autonomous coding.
[5] Anthropic. Patterns and problems in multiagent systems.
[6] The Cost of Consensus: Isolated Self-Correction Prevails Over Unguided Homogeneous Multi-Agent Debate. arXiv, 2026.